Performance Engineering auf Solana in 2026: Optimierung von Compute, Kosten und Latenz
Optimieren Sie Solana Compute Units, Priority Fees und End-to-End-Latenz im Jahr 2026 mit praxisnahen Anleitungen für zuverlässige Anwendungen in Produktionsqualität.
Inhaltsverzeichnis
Solana wurde für hochperformante Anwendungen entwickelt. Doch das Bauen auf einer schnellen Blockchain macht eine Anwendung nicht automatisch schnell. Eine Transaktion kann korrekt ausgeführt werden und dennoch schlecht konzipiert sein: etwa weil sie weit mehr Compute anfordert als nötig, eine unnötig hohe Priority Fee zahlt, zu lange auf dem Weg zu einem Leader verzögert wird, mit heiß umkämpften Accounts kollidiert oder scheinbar spurlos verschwindet, weil die Retry- und Bestätigungslogik nicht robust genug ist.
Dieser Unterschied ist entscheidend, da Solana-Anwendungen über Prototypen hinauswachsen und in den Bereichen Zahlungsverkehr, DeFi, Handelssysteme, Gaming, DePIN, Tokenisierung und anderen produktiven Workloads eingesetzt werden.
Im Jahr 2026 sollte Performance Engineering auf Solana daher als eine Disziplin der Softwarearchitektur behandelt werden und nicht als eine Optimierungsaufgabe in letzter Sekunde.
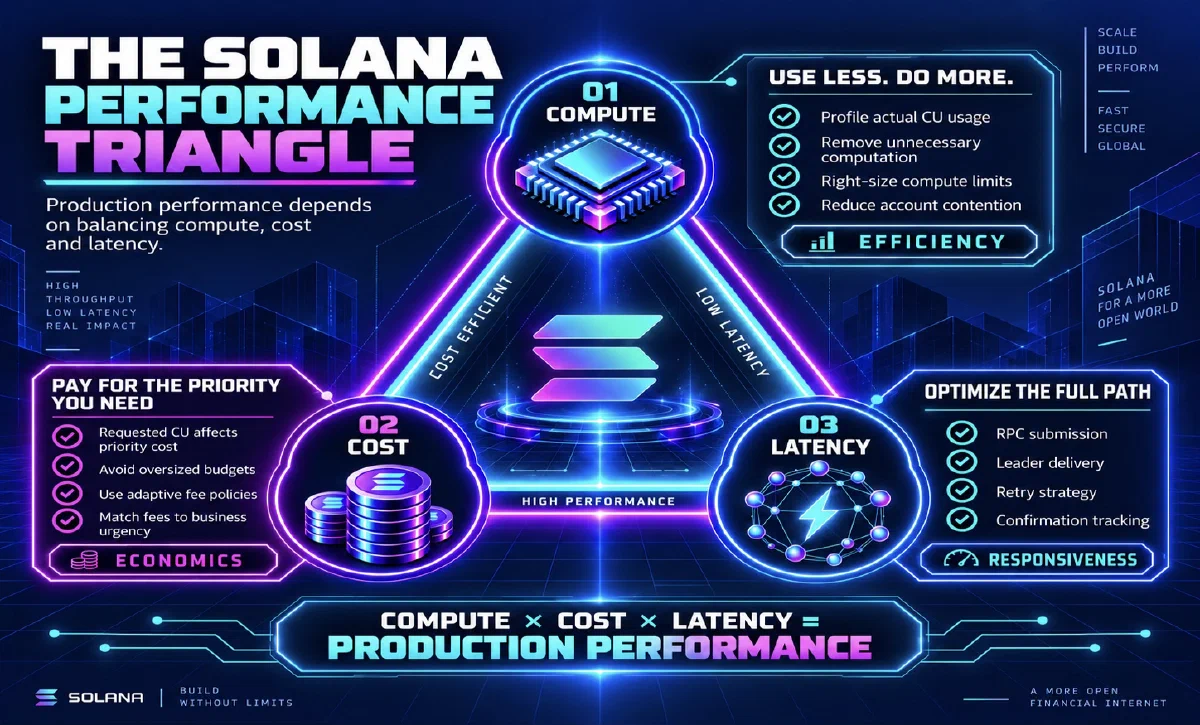
Das Ziel besteht nicht einfach darin, eine einzelne Instruktion günstiger zu machen. Es geht darum, drei miteinander verknüpfte Dimensionen zu optimieren: Compute-Effizienz, Transaktionsökonomie und End-to-End-Latenz. Wenn diese Dimensionen gemeinsam geplant und umgesetzt werden, lassen sich Anwendungen kostengünstiger betreiben, verhalten sich unter Last berechenbarer und bieten aus Nutzersicht eine deutlich bessere Erfahrung.
Warum Solana Performance Engineering im Jahr 2026 entscheidend ist
Die Architektur von Solana bietet Entwicklern einen ungewöhnlich großen Spielraum für Performance. Dennoch konkurrieren Anwendungen um endliche Ressourcen bei Ausführung, Netzwerkübertragung und Scheduling.
Jede Solana-Transaktion zahlt eine Gebühr in SOL. Das aktuelle Gebührenmodell kombiniert eine Basisgebühr (Base Fee) mit einer optionalen Priorisierungsgebühr (Prioritization Fee), welche die Wahrscheinlichkeit erhöht, dass eine Transaktion vor konkurrierenden Transaktionen eingeplant wird. Solana dokumentiert derzeit eine Basisgebühr von 5.000 Lamports pro Signatur. Solana Fees
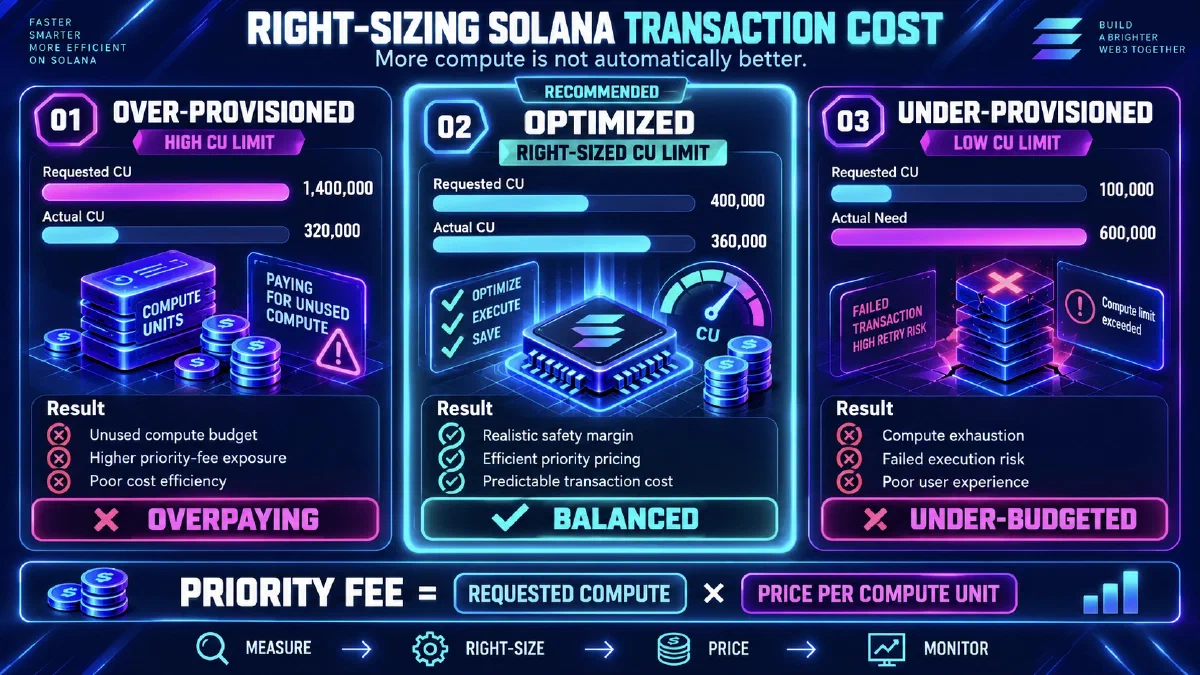
Compute wirkt sich direkt auf die Transaktionsökonomie aus. Für Legacy- und v0-Transaktionen dokumentiert Solana ein Standard-Kontingent von 200.000 Compute Units pro nicht-integrierter Instruktion (non-builtin instruction) und ein Maximum von 1,4 Millionen Compute Units pro Transaktion. Was noch schwerer wiegt: Die Priority Fee wird auf Basis des angeforderten Compute-Budgets berechnet – nicht nach der Menge, die letztendlich tatsächlich verbraucht wurde. Compute Budget
Unterdessen entwickelt sich das Netzwerk selbst weiter. Das XDP-Update der Solana Foundation für 2026 berichtet von einer überwältigenden Akzeptanz (Supermajority) von Kernel-Bypass-Networking und verknüpft diese Verbesserungen bei der Block-Ausbreitung (Propagation) mit der Einführung von 100-Millionen-Compute-Unit-Blöcken im Mainnet im Juli 2026. XDP auf Solana
Mehr Netzwerkkapazität ist wertvoll, ersetzt jedoch kein Engineering auf Anwendungsebene. Eine schlecht konzipierte Transaktions-Pipeline kann auch in einem schnelleren Netzwerk weiterhin Compute verschwenden, zu viel für Priorisierung bezahlen, Account-Konflikte (Account Contention) erzeugen oder Retries falsch handhaben.
Starten Sie mit Compute Units, nicht mit Vermutungen
Compute Units (CUs) sind Solanas Methode, um die für die Ausführung einer Transaktion erforderlichen Rechenressourcen zu erfassen. Der grundlegendste Optimierungsfehler besteht darin, Compute-Limits nach Gefühl festzulegen.
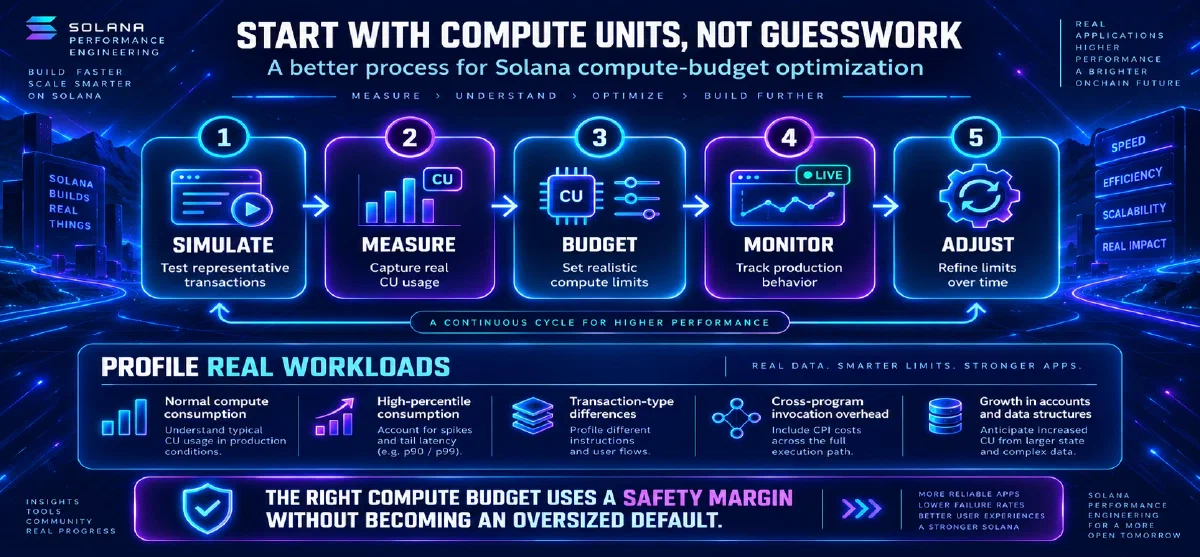
Die aktuelle Dokumentation zum Compute Budget von Solana empfiehlt, die Transaktion zu simulieren, den tatsächlichen CU-Verbrauch zu messen und einen moderaten Sicherheitsaufschlag hinzuzufügen, anstatt sich auf überdimensionierte Standardwerte zu verlassen. Die Dokumentation veranschaulicht explizit einen Sicherheitsaufschlag von 10 % nach der Simulation. Solana Compute Budget
Für Produktionssysteme bedeutet dies, repräsentative Workloads zu profilieren, anstatt nur eine einzige, ideale Transaktion zu betrachten. Sinnvolle Profile umfassen:
- Normalen Compute-Verbrauch
- Verbrauch im hohen Perzentilbereich
- Unterschiede zwischen verschiedenen Transaktionstypen
- Durch Cross-Program Invocations (CPI) eingebrachten Compute-Aufwand
- Die Veränderung des Verbrauchs, wenn Accounts oder Datenstrukturen wachsen
Das richtige Compute-Budget sollte genügend Sicherheitsmarge für realistische Ausführungsschwankungen bieten, ohne zu einem übermäßig großen Standardwert zu werden, der pauschal überall angewendet wird.
Unnötige Arbeit On-Chain reduzieren
Die Optimierung von Compute kann auch tieferliegende Architekturprobleme aufdecken.
Wiederholte Serialisierung, unnötiges Logging, teure Datenstrukturen, redundante Account-Prüfungen, exzessive Cross-Program Invocations und vermeidbare Zustandstransformationen verbrauchen wertvolle Ressourcen.
Ein paar hundert Compute Units mögen während der Entwicklung irrelevant erscheinen. Bei einer Anwendung mit hohem Transaktionsvolumen schlagen sie jedoch spürbar auf die Wirtschaftlichkeit der gesamten Plattform durch.
Deshalb betrachten erfahrene Teams die CU-Optimierung nicht als isoliertes Tuning von Smart Contracts. Sie stellen eine grundlegendere Frage: Findet diese Berechnung überhaupt im richtigen Teil der Architektur statt?
Manche Aufgaben gehören zwingend On-Chain, weil sie deterministisch und vertrauenswürdig sein müssen. Andere Arbeiten können andernorts vorbereitet, aggregiert, gecacht, indiziert oder validiert werden. Gutes Performance Engineering identifiziert genau diese Grenze.
Entwickeln Sie für Parallelität und vermeiden Sie Account Contention
Das Ausführungsmodell von Solana kann unabhängige Transaktionen parallel verarbeiten, da Transaktionen vorab deklarieren, auf welche Accounts sie zugreifen wollen. Dies ist ein erheblicher architektonischer Vorteil, bringt jedoch eine wesentliche Konsequenz mit sich: Eine parallele Ausführung bringt nur dann Vorteile, wenn die Workloads auch tatsächlich parallelisierbar sind.
Transaktionen, die einen konkurrierenden Schreibzugriff (conflicting write access) auf dieselben Accounts erfordern, können schlichtweg nicht gleichzeitig ausgeführt werden.
Wissenschaftliche Analysen historischer Blockchain-Workloads beschreiben Solana als ein System mit einem Read-Write-sensitiven Ausführungsmodell, bei dem der Zustandszugriff im Voraus deklariert wird. Dieselbe Forschung zeigt, dass Transaktionskonflikte die nutzbare Parallelität stark einschränken können. Transaktionskonflikt-Studie
Für Anwendungsarchitekten macht dies das Account-Design zu einer zentralen Performance-Frage. Betrachten Sie ein System, in dem Tausende ansonsten unabhängiger Aktionen alle in einen einzigen, gemeinsam genutzten Account schreiben müssen. Das einzelne Programm mag effizient sein; die Architektur ist es nicht.
- Welche Accounts entwickeln sich zu Hotspots („hot accounts“)?
- Welche Schreibvorgänge lassen sich entkoppeln?
- Kann der Zustand partitioniert werden?
- Serialisiert eine einzige globale Struktur unnötigerweise Aktivitäten, die andernfalls parallel ausgeführt werden könnten?
Dies ist besonders wichtig für hochfrequentierte DeFi-Projekte, Marktplätze, Handelsinfrastrukturen, Spiele und andere Systeme, bei denen Transaktionsspitzen auf denselben Zustand abzielen.
Optimieren Sie Priority Fees, statt sie fest im Code zu hinterlegen
Niedrige Transaktionskosten gehören zu den Hauptargumenten für Solana. Doch „niedrige Kosten“ dürfen nicht mit einer fehlenden Gebührenstrategie („no fee strategy“) verwechselt werden. Ein Produktionssystem muss im jeweiligen Moment entscheiden, wie viel eine erfolgreiche Transaktion wert ist.
Bei Legacy- und v0-Transaktionen leitet sich die Priorisierungsgebühr aus dem angeforderten Compute-Unit-Limit und dem gewählten Compute-Unit-Preis ab. Vereinfacht gesagt: angeforderter Compute × Preis pro Compute Unit. Die exakte Gebührenberechnung rechnet Micro-Lamports in Lamports um und rundet auf. Gebührenstruktur
Daraus ergeben sich zwei Variablen, die gemeinsam optimiert werden müssen: das Compute Unit Limit, das angibt, wie viel Rechenleistung die Transaktion maximal nutzen darf, und der Compute Unit Price, der bestimmt, wie viel Priorität eingekauft wird.
Nur eine dieser Variablen zu optimieren, greift zu kurz.
Warum statische Priority Fees eine schwache Architektur sind
Stellen Sie sich vor, Sie wenden für jede Aktion in Ihrer Anwendung dieselbe Priority Fee an. In Zeiten geringer Auslastung zahlen Sie konsequent zu viel. Bei hoher Netzwerklast hingegen bietet dieselbe Gebühr möglicherweise nicht die nötige Zuverlässigkeit für zeitkritische Transaktionen. Zudem haben unterschiedliche Geschäftsprozesse nicht dieselbe Dringlichkeit.
Ein Nutzer, der einen zeitkritischen Trade platziert, bewertet eine schnelle Ausführung völlig anders als eine Hintergrundanwendung, die unkritische Statusdaten speichert. Eine bessere Architektur klassifiziert Transaktionen nach ihrer geschäftlichen Relevanz.
| Transaktionstyp | Latenzsensitivität | Empfohlene Strategie |
|---|---|---|
| Hintergrund-Wartung | Niedrig | Konservative Priorität |
| Standard-Nutzeraktion | Mittel | Adaptive Priorität |
| Zahlung / wichtige Statusänderung | Hoch | Stärkere dynamische Priorität |
| Trading / Liquidation / zeitkritische Ausführung | Sehr hoch | Aggressive, latenzbewusste Strategie |
Die exakten Werte sollten sich an den aktuellen Netzwerkbedingungen und der Dringlichkeit der Transaktion orientieren – nicht an einer dauerhaft festen Konstante im Quellcode. Dies ist eine allgemein gültige Lektion für Softwarearchitekten: Die Infrastruktur-Steuerung sollte stets den geschäftlichen Nutzen widerspiegeln.
Transaktionslatenz beginnt vor der Ausführung
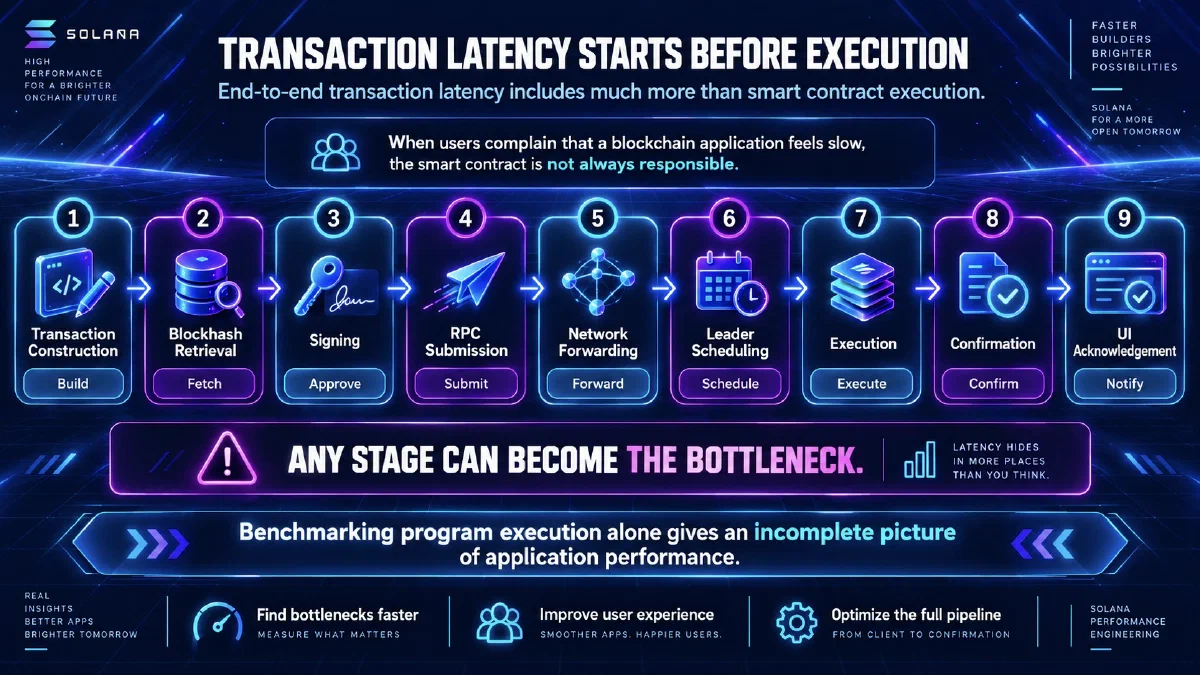
Wenn sich Nutzer darüber beschweren, dass sich eine Blockchain-Anwendung langsam anfühlt, liegt die Verantwortung dafür nicht immer beim Smart Contract.
Jede dieser Phasen kann zum Nadelöhr werden. Aus diesem Grund liefert das bloße Benchmarking der Programmausführung ein unvollständiges Bild der tatsächlichen Performance.
Die RPC-Architektur ist entscheidend
Anwendungen hängen häufig von einem RPC-Anbieter ab, um Transaktionen zu senden und zu überwachen.
Die Retry-Dokumentation von Solana erklärt, dass Transaktionen verworfen werden können, bevor sie in einen Block aufgenommen werden. Bei hoher Netzwerkauslastung reicht das generische RPC-Rebroadcasting (erneutes Senden durch den RPC-Knoten) für manche Anwendungen nicht aus. Latenzsensitive Systeme benötigen daher oft eine anwendungsspezifische Rebroadcast-Logik. Retrying Transactions
RPC-Pools bringen ein weiteres, subtiles Problem mit sich: Wenn ein Backend dem anderen voraus ist, wird ein vom weiter fortgeschrittenen Backend abgerufener, aktueller Blockhash vom empfangenden Backend möglicherweise noch nicht erkannt. Die Folge: Die Transaktion wird direkt verworfen.
Das ist kein Problem des Smart Contracts, sondern ein klassisches Problem verteilter Systeme. Die Solana-Entwicklung profitiert daher enorm von denselben Denkweisen, wie sie für hochperformante Backend-Systeme angewendet werden.
Entwickeln Sie eine robuste Retry-Logik als Teil des Transaktionslebenszyklus
Eine erfolgreiche Rückmeldung von sendTransaction bedeutet nicht, dass die Transaktion bereits ausgeführt oder finalisiert wurde. Sie besagt lediglich, dass der RPC-Endpunkt die übermittelte Transaktion zur Weiterleitung angenommen hat. Software für den Produktivbetrieb muss den gesamten Lebenszyklus einer Transaktion verstehen.
Solana-Transaktionen, die auf einem aktuellen Blockhash basieren, haben ein begrenztes Gültigkeitsfenster. Die Dokumentation zur Transaktionsbestätigung erklärt, dass Validatoren Blockhashes nur innerhalb der letzten 151 Einträge akzeptieren. Dies entspricht – je nach Slot-Dauer – in der Regel etwa 60 bis 90 Sekunden. Transaction Confirmation & Expiration
Anwendungen haben somit nur ein zeitlich eng begrenztes Fenster für Wiederholungsversuche. Ein robuster Transaktions-Manager sollte Folgendes wissen:
- Die Transaktionssignatur
- Die letzte gültige Blockhöhe (Last Valid Block Height)
- Ob die Transaktion bereits in einem Block gelandet ist (Landed)
- Ob sie noch gültig ist
- Wann ein Rebroadcast sinnvoll ist
- Wann eine neue Transaktion konstruiert werden muss
Wiederholungsversuche sollten kontrolliert ablaufen, anstatt die Endpunkte mit Anfragen zu fluten. Die Best-Practices-Anleitungen von Solana für den Produktivbetrieb empfehlen eine explizite Verlaufsverfolgung (Expiration Tracking), kontrollierte Retries und Backoff-Verhalten. Production Readiness
Was ist mit skipPreflight?
Hierauf gibt es keine allgemeingültige Antwort.
Die Produktionsrichtlinien von Solana weisen darauf hin, dass skipPreflight: true die Latenz beim Senden verringern kann, wenn eine Transaktion bereits an anderer Stelle validiert wurde. Während der Entwicklung ist es jedoch ratsam, Preflight aktiviert zu lassen, da Simulationen Fehler aufdecken können, noch bevor die Transaktion gesendet wird.
Genau um diese Abwägungen geht es beim Performance Engineering. Die entscheidende Frage lautet nicht einfach: „Welche Option ist schneller?“, sondern „Welche Abwägung zwischen Zuverlässigkeit und Latenz ist für diesen spezifischen Workload angemessen?“
Denken Sie über RPC hinaus: Transaktionszustellung ist Teil der Architektur
Anwendungsentwickler müssen auch verstehen, was mit einer Transaktion passiert, nachdem sie ihre eigene Infrastruktur verlassen hat.
Mit Stake-weighted Quality of Service (QoS) können Solana-Leader Transaktionen identifizieren und priorisieren, die über Staked Validators geleitet werden. Dies dient als zusätzlicher Sybil-Schutzmechanismus. Für latenzsensitive Anwendungen zeigt dies einmal mehr, dass die erfolgreiche Zustellung einer Transaktion von weit mehr abhängt als nur von einem HTTP-Request an einen RPC-Knoten. Stake-weighted QoS
Je nach Workload muss die Systemarchitektur Folgendes berücksichtigen:
- RPC-Qualität und -Erreichbarkeit
- Geografische Platzierung
- Verbindungsmanagement (Connection Management)
- Transaktions-Routing
- Anbindung an Validatoren
- Lastabhängige Gebührenschätzung (Congestion-aware Fee Estimation)
- Retry-Verhalten
- Observability (Überwachbarkeit)
Dies ist vor allem für Produkte relevant, bei denen ein Unterschied von wenigen hundert Millisekunden spürbare Auswirkungen auf den Nutzer oder das Geschäft hat.
Messen Sie, was Nutzer tatsächlich erleben
Performance Engineering scheitert, wenn Teams nur das optimieren, was sich leicht messen lässt. Der CU-Verbrauch eines Programms ist nützlich. Die RPC-Antwortzeit ist ebenfalls wichtig. Doch keines von beiden bildet die gesamte Nutzererfahrung ab.
Für produktive Solana-Anwendungen sind unter anderem folgende Kennzahlen (Metrics) wertvoll:
Compute
- Tatsächlich verbrauchte CUs pro Transaktionstyp
- Angefordertes vs. verbrauchtes Compute-Budget
- Fehlgeschlagene Ausführungen aufgrund überschrittener Compute-Limits
Gebühren (Fees)
- Priority Fee pro erfolgreicher Transaktion
- Gebührenverteilung nach Transaktionsklasse
- Kosten pro abgeschlossener Geschäftstransaktion
Übermittlung (Submission)
- Erfolgsquote bei der Übermittlung (Submission Success Rate)
- Anzahl der Rebroadcasts
- Rate abgelaufener Blockhashes (Blockhash Expiration Rate)
- Rate verworfener Transaktionen (Dropped Transaction Rate)
Latenz (Latency)
- Latenz von der Signierung bis zur Aufnahme im Block (Signature-to-Landed Latenz)
- Latenz von der Aufnahme im Block bis zur Bestätigung (Landed-to-Confirmed Latenz)
- Latenz von der Nutzeraktion bis zur Bestätigung (User-Action-to-Confirmation Latenz)
- p50 / p95 / p99-Latenzen statt bloßer Durchschnittswerte
Zuverlässigkeit (Reliability)
- Transaktions-Erfolgsquote (Transaction Completion Rate)
- Anzahl der Retries pro erfolgreicher Transaktion
- Kategorisierung von Fehlern nach Ursachen (Anwendung, RPC, Netzwerk, Smart Contract)
Observability verwandelt die Optimierung von einer gelegentlichen Aufgabe in einen kontinuierlichen Feedback-Kreislauf.
Performance Engineering ist letztlich Architekturentwurf
Es gibt einen Punkt, an dem Performance-Probleme aufhören, lokale Code-Probleme zu sein.
Wenn ein Programm wiederholt an Compute-Limits stößt, liegt das Problem meist in seiner Architektur. Wenn die Priority Fees kontinuierlich steigen, liegt es oft am Transaktionsdesign. Wenn Transaktionen häufig kollidieren, muss vermutlich das Account-Modell überarbeitet werden. Wenn Nutzer unvorhersehbare Bestätigungszeiten erleben, muss eventuell die RPC- und Übermittlungs-Infrastruktur neu konzipiert werden.
Wenn jede Optimierung immer komplexere Workarounds erfordert, benötigt das System eine Architekturanalyse anstelle eines weiteren Patches.
Bei trust!NICKOL betrachten wir Softwarearchitektur und deren Implementierung als untrennbare Disziplinen. Vor allem Solana-Systeme profitieren von der Kombination aus Blockchain-spezifischem Engineering und performance-orientiertem Softwaredesign, Rust, verteilten Systemen, Zuverlässigkeit und produktionsreifer Architektur.
Das Ziel sollte nicht darin bestehen, den raffiniertesten Smart Contract zu schreiben. Das Ziel muss sein, ein System zu bauen, das auch dann berechenbar und zuverlässig funktioniert, wenn echte Nutzer, echtes Geld und echter Produktions-Traffic eintreffen.
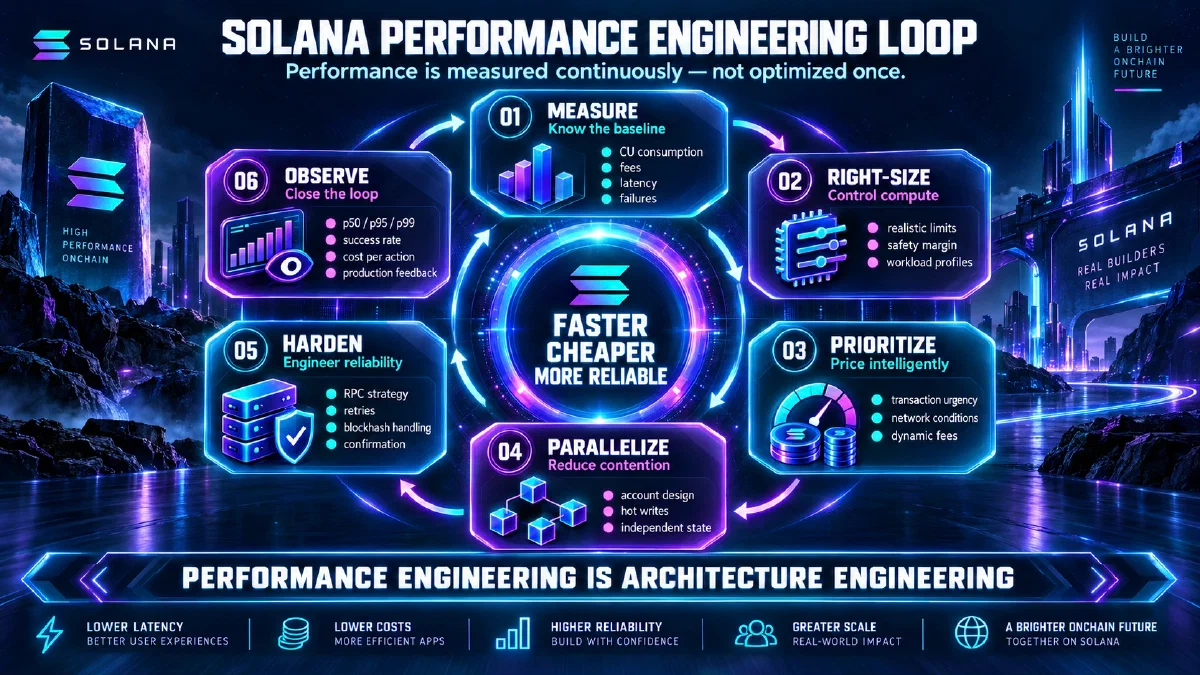
Ein praktischer Workflow für Solana Performance Engineering
- Messen: Profilieren Sie den Compute-Verbrauch, Gebühren, Latenzen, Fehler und das Bestätigungsverhalten.
- Optimale Dimensionierung: Legen Sie realistische Compute-Budgets auf Basis von Messungen fest, anstatt Standardwerte zu nutzen.
- Priorisieren: Richten Sie die Gebührenpolitik an der Dringlichkeit der Transaktion und den aktuellen Netzwerkbedingungen aus.
- Parallelisieren: Erkennen Sie Account-Konflikte (Account Contention) und entkoppeln Sie unnötig serialisierte Zugriffspunkte.
- Absichern (Harden): Verbessern Sie die RPC-Architektur, das Blockhash-Handling, die Bestätigungsverfolgung, Retries und die Observability.
- Beobachten und Neubewerten: Wiederholen Sie diesen Zyklus, da sich die Anwendungsnutzung, die Netzwerkbedingungen und Solana selbst ständig weiterentwickeln.
Ausblick: Solanas Transaktionsmodell entwickelt sich weiter
Teams sollten vermeiden, ihre Architektur fest an heutige Annahmen zu binden. Die aktuelle Dokumentation zu Versioned Transactions von Solana beschreibt ein kommendes v1-Format, welches das Limit für die Transaktionsgröße auf 4.096 Bytes anhebt, Ressourcenlimits direkt in die Nachricht verlagert und Address Lookup Tables (ALTs) entfernt. Laut Dokumentation ist v1 zum Zeitpunkt der Erstellung dieses Beitrags noch auf keinem Cluster aktiv. Versioned Transactions
Dieser Unterschied ist wesentlich. Eine solide Architektur sollte auf dem aufbauen, was heute verfügbar ist, und gleichzeitig anpassungsfähig für zukünftige Entwicklungen bleiben. Zukunftssicheres Engineering bedeutet nicht, unveröffentlichte Funktionen verfrüht einzuführen. Es bedeutet vielmehr, Annahmen zu vermeiden, die eine spätere Migration unnötig teuer machen würden.
Auch die Client-Infrastruktur sollte darauf vorbereitet sein, die höchste von ihr unterstützte Transaktionsversion zu deklarieren, damit RPC-Antworten nicht fehlschlagen, sobald neuere Formate eingeführt werden.
Das Wichtigste auf einen Blick
- Solanas hohe Netzwerk-Performance macht Performance Engineering auf Anwendungsebene nicht überflüssig.
- Compute-Unit-Anforderungen sollten gemessen und präzise dimensioniert werden, anstatt sie großzügig überzuprovisionieren.
- Angefordertes Compute-Budget und Priority Fees müssen aufeinander abgestimmt optimiert werden.
- Das Account-Design entscheidet darüber, wie viel Parallelität eine Anwendung tatsächlich nutzen kann.
- Die End-to-End-Latenz umfasst Blockhash-Abruf, Signierung, RPC-Übermittlung, Routing, Scheduling, Ausführung, Bestätigung und das Feedback in der Anwendung.
- Transaktions-Retries und das Ablaufen von Blockhashes müssen explizit im Code konzipiert und umgesetzt werden.
- Performance-Metriken sollten das technische Verhalten direkt mit der realen Nutzererfahrung verknüpfen.
- Hartnäckige Performance-Probleme sind meist Architekturprobleme und keine isolierten Code-Herausforderungen.
Fazit
Solana bietet ein beeindruckendes, hochperformantes Fundament, und das Netzwerk selbst entwickelt sich kontinuierlich weiter. Doch Infrastruktur-Performance und Anwendungs-Performance sind nicht dasselbe.
Solana-Systeme in Produktionsqualität erfordern bewusste Entscheidungen über Compute-Ressourcen, Transaktionsökonomie, Account-Zugriffe, RPC-Infrastruktur, Retry-Verhalten, Observability und die Softwarearchitektur.
Die erfolgreichsten Engineering-Teams fragen daher nicht nur: „Wie viele Transaktionen kann Solana verarbeiten?“, sondern vielmehr: „Wie effizient und zuverlässig nutzt unsere Anwendung die Performance, die Solana bereitstellt?“
Diese Frage entscheidet letztlich darüber, ob eine Solana-Anwendung lediglich funktioniert oder ob sie bereit ist, erfolgreich zu skalieren.
Häufig gestellte Fragen (FAQ)
Was ist eine Compute Unit auf Solana?
Eine Compute Unit (CU) ist Solanas Maßeinheit für den Rechenaufwand während der Transaktionsausführung. Transaktionen laufen innerhalb eines festgelegten Compute-Budgets ab, weshalb der CU-Verbrauch sowohl für die Programmeffizienz als auch für die Wirtschaftlichkeit der Transaktion entscheidend ist.
Macht das Anfordern von mehr Compute eine Transaktion schneller?
Nicht unbedingt. Zusätzlicher Compute beschleunigt eine ineffiziente Programmlogik nicht. Zudem basiert bei Legacy- und v0-Transaktionen die Priorisierungsgebühr auf dem angeforderten und nicht auf dem tatsächlich verbrauchten Compute-Budget. Eine Überdimensionierung des Limits erhöht somit die Kosten, ohne das eigentliche Performance-Nadelöhr zu beseitigen.
Sind Priority Fees immer notwendig?
Nein. Ob sie sinnvoll sind, hängt von der Netzwerkauslastung, der Dringlichkeit der Transaktion und den Zuverlässigkeitsanforderungen der Anwendung ab. Eine dynamische Anpassungsstrategie ist meist weitaus sinnvoller, als eine statische Gebühr für alle Operationen festzulegen.
Warum kann eine gültige Solana-Transaktion verworfen werden („dropped“)?
Transaktionen können durch Netzwerkauslastung (Congestion), das Rebroadcast-Verhalten von RPCs, Synchronisationsprobleme bei Blockhashes, allgemeine Netzwerkbedingungen oder temporäre Forks beeinträchtigt werden, bevor sie erfolgreich in einen Block aufgenommen und bestätigt werden.
Ist die Performance-Optimierung auf Solana primär ein Smart-Contract-Problem?
Nein. Der Programmcode ist nur eine von vielen Ebenen. Die Account-Architektur, der Transaktionsaufbau, die RPC-Infrastruktur, Priority Fees, die Retry-Strategie, das Handling von Bestätigungen und das Verhalten der Benutzeroberfläche tragen alle zur Gesamt-Performance bei.
Wann wird ein Solana-Performance-Problem zu einem Architektur-Problem?
Wenn Nadelöhre wiederholt bei Compute-Limits, Account-Konflikten, der Transaktionszustellung, dem RPC-Verhalten, Retries oder der Observability auftreten, reicht lokales Tuning oft nicht mehr aus. In diesem Fall kann eine Architekturanalyse aufzeigen, welche Systemgrenzen oder Infrastrukturentscheidungen die Performance einschränken.
Quellen und weiterführende Literatur
- Solana Documentation — Fees — Basisgebühren, Priorisierungsgebühren und Gebührenmechanik.
- Solana Documentation — Compute Budget — CU-Limits, Zusammenhang mit Priority Fees, Richtlinien zur Sicherheitsmarge und Ressourcengrenzen.
- Solana Documentation — Fee Structure — Aktuelle Gebührenformeln für Legacy- und v0-Transaktionen.
- Solana Cookbook — Retrying Transactions — Verworfene Transaktionen, Rebroadcasting und Steuerung von Wiederholungsversuchen.
- Solana Cookbook — Transaction Confirmation & Expiration — Gültigkeit von Blockhashes, Ablaufzeiten und Bestätigungsverhalten.
- Solana Documentation — Production Readiness — Praktische Einstellungen für Transaktionsübermittlung und Retries im Produktivbetrieb.
- Solana Documentation — Stake-weighted QoS — Dienstgüte (Quality of Service) für die Transaktionszustellung über prioritäre Staked-Validator-Pfade.
- Solana — XDP High-Performance Networking — Validator-Networking und Verbesserungen der Block-Ausbreitung im Jahr 2026.
- Solana Cookbook — Versioned Transactions — Aktuelle Transaktionsversionen und künftiges Verhalten der Version v1.
- Solana Whitepaper — A New Architecture for a High Performance Blockchain — Fundamente der Architektur und Hintergrund zu Proof of History.
- Anjana, Ravi & Herlihy — Blockchain Transaction Conflicts: A Historical Perspective — Empirische Analyse von Transaktionskonflikten und Parallelität, inklusive Solana.
- Dynamic Pricing for Non-fungible Resources: Designing Multidimensional Blockchain Fee Markets — Wissenschaftliche Hintergründe zur Preisgestaltung heterogener Blockchain-Ressourcen.

Alexander Nickol
Software-Architekt und Entwickler
Ich begeistere mich für Programmiersprachen und Softwarearchitektur. Ich biete eine große Bandbreite an Fähigkeiten, unternehmerisches Handeln und lösungsorientiertes Denken in Bereichen wie Softwarearchitektur, Softwaredesign und Softwareentwicklung in Rust und Java.
Ähnliche Artikel
Das Strangler-Fig-Pattern: Legacy-Systeme schrittweise mit Rust modernisieren
Erfahren Sie, wie das Strangler-Fig-Pattern Legacy-Systeme schrittweise durch Rust-Microservices ersetzt und die Risiken einer komplexen Systemmigration senkt.
KI-gestützte Softwareentwicklung in 2026: Wie Sie Coding-Agents ohne technische Schulden einsetzen
Erfahren Sie, wie Coding-Agents die Softwarebereitstellung in 2026 verändern, wo sie den größten Nutzen bringen und welche architektonischen Leitplanken technische Schulden verhindern.
C++ zu Rust migrieren: Schrittweise modernisieren ohne Full Rewrite
Erfahren Sie, wie Unternehmen bestehende C++-Systeme schrittweise mit Rust modernisieren, Risiken begrenzen und einen teuren Full Rewrite vermeiden.