KI-gestützte Softwareentwicklung in 2026: Wie Sie Coding-Agents ohne technische Schulden einsetzen
Erfahren Sie, wie Coding-Agents die Softwarebereitstellung in 2026 verändern, wo sie den größten Nutzen bringen und welche architektonischen Leitplanken technische Schulden verhindern.
Inhaltsverzeichnis
KI-gestützte Softwareentwicklung dreht sich im Jahr 2026 nicht mehr nur um schnellere Code-Autovervollständigung. Coding-Agents können heute Repositories analysieren, mehrere Dateien gleichzeitig ändern, Befehle und Tests ausführen, asynchron arbeiten und Pull Requests zur Überprüfung vorbereiten. Das schafft enorme Hebelwirkung, verändert aber auch das Risikoprofil der Softwarebereitstellung grundlegend. Der eigentliche Engpass ist nicht mehr, wie schnell Code generiert werden kann; die entscheidende Frage ist, ob Ihre Architektur, Ihre CI/CD-Pipeline, Ihr Review-Prozess, Ihre Sicherheitskontrollen und Ihre Engineering-Organisation diese Geschwindigkeit absorbieren können, ohne die heutigen Produktivitätsgewinne in die Wartungskosten von morgen zu verwandeln.
Dieser Artikel beleuchtet, wo Coding-Agents echten Mehrwert schaffen, an welchen Stellen sie technische Schulden beschleunigen können und welche Leitplanken Teams dabei helfen, die Autonomie der Agents zu erhöhen, ohne die architektonische Kontrolle zu verlieren.
KI-gestützte Softwareentwicklung geht weit über Autocomplete hinaus
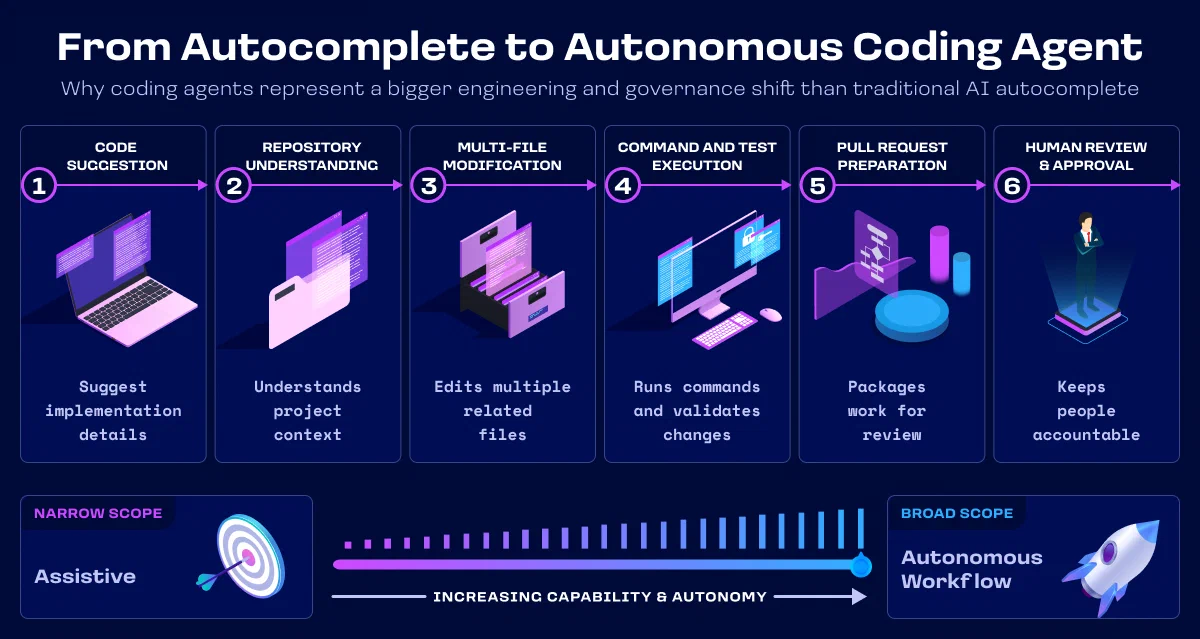
Ein KI-Coding-Assistent unterstützt Entwickler in erster Linie dabei, Code zu schreiben, zu verstehen oder zu transformieren. Ein Coding-Agent geht einen wesentlichen Schritt weiter: Er kann eine Aufgabe übernehmen, eine Abfolge von Aktionen planen, Entwicklungswerkzeuge nutzen und eine überprüfbare Änderung zurückgeben. Moderne GitHub-Workflows ermöglichen es Coding-Agents beispielsweise, asynchron zu arbeiten und Pull Requests zu erstellen, während Plattformen wie Codex mehrstufige Aufgaben wie Features, Refactorings und Migrationen unterstützen.
| Fähigkeit | Coding-Assistent | Coding-Agent |
|---|---|---|
| Interaktionsmodell | Reaktiv (Autovervollständigung & Chat) | Autonom (Zielgerichtete Ausführung) |
| Aktionsradius | Einzelne Datei oder lokale Code-Schnipsel | Dateiübergreifende Orchestrierung & Refactoring |
| Kontextbewusstsein | Aktive Datei & eingeschränkter lokaler Kontext | Umfassendes Verständnis des gesamten Workspaces |
| Tool-Ausführung | Nur Lesezugriff / Erfordert menschliche Ausführung | Führt Builds, Tests und Shell-Befehle aus |
| Komplexität der Aufgaben | Einschrittig (z. B. „Schreibe eine Funktion“) | Mehrstufig (Recherche, Planung, Ausführung, Verifizierung) |
| Fehlerbehandlung | Mensch muss Fehler diagnostizieren und neuen Prompt senden | Selbstkorrigierend (Analysiert Logs und unternimmt neuen Versuch) |
Der entscheidende Unterschied liegt im Entscheidungsspielraum. Autocomplete schlägt ein Implementierungsdetail vor. Ein Agent hingegen kann mehrere Implementierungsentscheidungen über ein gesamtes Repository hinweg treffen, bevor ein Entwickler überhaupt das resultierende Diff sieht. Aus diesem Grund ist agentenbasierte Entwicklung nicht nur eine Frage der Produktivität. Sie ist auch eine Frage der Architektur, Sicherheit und Governance.
Warum Coding-Agents technische Schulden beschleunigen können
- Technische Schulden sind kein Synonym für schlechten Code. Sie sind die zukünftigen Kosten, die entstehen, wenn heutige Implementierungsentscheidungen die Änderungen von morgen schwerer verständlich, modifizierbar, testbar, sicher oder betreibbar machen.
- Coding-Agents erzeugen nicht automatisch technische Schulden. Das Risiko entsteht, wenn die Kosten für das Generieren einer Änderung drastisch sinken, während die Kosten für das Verstehen ihrer architektonischen Konsequenzen gleich bleiben.
- Die DORA-Forschung von 2025 beschreibt KI als Verstärker. In ihrer Studie mit fast 5.000 Technologieexperten war eine höhere KI-Adoption mit stärkerem Durchsatz bei der Softwarebereitstellung und Produktleistung verbunden, während die Lieferstabilität weiterhin eine negative Beziehung aufwies. Die praktische Lehre ist einfach: Schnellere Veränderungen können Schwachstellen an anderen Stellen des Bereitstellungssystems gnadenlos offenlegen.
Code, der funktioniert, ist nicht automatisch Code, der passt
Stellen Sie sich vor, Sie bitten einen Agenten, Kundenbenachrichtigungen hinzuzufügen. Die Änderung besteht die vorhandene Testsuite, aber der Agent führt gleichzeitig eine zweite Benachrichtigungsabstraktion ein, liest Kundendaten direkt aus den Datenbanktabellen eines anderen Moduls, fügt eine neue Bibliothek für Funktionen hinzu, die intern bereits vorhanden sind, und platziert die Domänenlogik direkt in einem API-Controller.
- Funktional funktioniert das Feature.
- Architektonisch ist das System schlechter geworden.
Dies ist der Unterschied zwischen lokaler Korrektheit und architektonischer Korrektheit. Tests können das erwartete Verhalten verifizieren, aber sie beweisen nicht automatisch, dass eine Änderung Domänengrenzen, Abhängigkeitsregeln, Datenbesitz, Sicherheitsanforderungen oder die beabsichtigte Richtung des Gesamtsystems respektiert.
Schnellere Code-Generierung kann den Engpass ins Review verlagern
- KI verändert auch die Ökonomie von Code-Reviews. Das Erstellen eines weiteren Pull Requests mag kostengünstig sein, aber seine Überprüfung erfordert nach wie vor einen Menschen, der die Anforderungen, die Architektur, potenzielle Fehlerquellen und die langfristigen Wartungskosten versteht.
- Der DORA-ROI-Leitfaden von Google aus dem Jahr 2026 hebt denselben Systemeffekt hervor: Wenn Entwickler Änderungen schneller produzieren, werden nachgelagerte Test- und Freigabeprozesse zum Engpass, es sei denn, die Bereitstellungspipeline entwickelt sich parallel dazu weiter.
- GitHub empfiehlt daher, von Agenten erstellte Pull Requests mit der gleichen Strenge zu prüfen wie alle anderen Beiträge. Schnellere Generierung ersetzt nicht die Notwendigkeit menschlicher Ingenieursleistung.
Wo Coding-Agents den größten Nutzen bringen
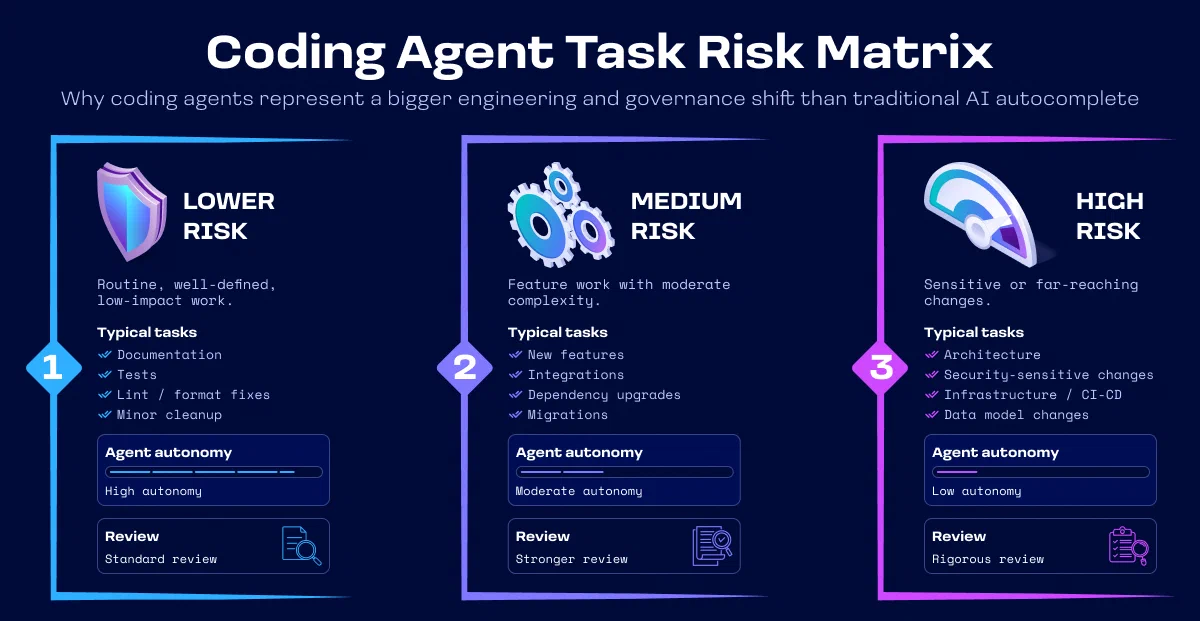
Das sicherste Adoptionsmodell ist die begrenzte Autonomie (Bounded Autonomy): Geben Sie einem Agenten genügend Freiraum, um nützliche Arbeit zu leisten, während Sie die Aufgabe, die Berechtigungen und die Abnahmekriterien je nach Risiko begrenzen.
| Risiko | Geeignete Beispiele | Aufsicht |
|---|---|---|
| Geringes | Dokumentation, Testgerüste (Scaffolding), Lint-Fehlerbehebungen, klar definierte Refactorings | Normale CI und normales Review |
| Mittleres | Features, Integrationen, Änderungen von Abhängigkeiten, Migrationen mit klaren Akzeptanzkriterien | Stärkere Tests und Reviews durch erfahrene Entwickler |
| Hohes | Authentifizierung, Architekturgrenzen, Produktionsinfrastruktur, sensible Daten, irreversible Migrationen | Menschliche Entscheidungsfindung |
Der entscheidende Faktor sollte nicht sein, wie fähig der Agent erscheint. Es sind die Kosten, die Auswirkungen und die Reversibilität einer Fehlentscheidung.
Sieben Leitplanken für den Einsatz von Coding-Agents ohne technische Schulden
1. Machen Sie Ihre Architektur für Agents lesbar
Agents können Regeln nicht zuverlässig befolgen, wenn sie diese nicht finden können. Halten Sie wichtige architektonische Leitlinien nah am Repository: Modulgrenzen, Datenbesitz, freigegebene Abhängigkeiten, API-Konventionen, Testerwartungen, Sicherheitsbeschränkungen, Architecture Decision Records (ADRs) und Muster, die nicht eingeführt werden sollten. Das Ziel ist nicht mehr Dokumentation, sondern aktueller, umsetzbarer Kontext, der Menschen und Agents hilft zu verstehen, wie sich das System entwickeln soll.
2. Halten Sie von Agents generierte Änderungen klein
„Modernisiere das Backend“ ist zu umfassend, um es sicher zu reviewen. Eine Aufgabe wie „Extrahiere dieses Modul hinter das bestehende Interface, migriere einen Consumer, bewahre den aktuellen Vertrag und führe diese Tests aus“ ist weitaus einfacher zu verifizieren. Kleine Änderungen reduzieren die kognitive Belastung der Reviewer, decken Annahmen früher auf und machen einen Rollback einfacher, falls der Agent die Anforderungen missverstanden hat.
3. Stärken Sie automatisierte Qualitätsprüfungen vor Erhöhung der Autonomie
Von Agents generierter Code sollte dieselben Engineering-Kontrollen durchlaufen wie von Menschen geschriebener Code. Je nach System kann dies Unit- und Integrationstests, Typprüfungen, statische Analysen, Linting, API-Vertragstests, Dependency-Scanning, Secret-Erkennung und Sicherheitsanalysen umfassen. Automatisierte Prüfungen können das architektonische Urteil nicht ersetzen, aber sie sind die erste skalierbare Verteidigungslinie, wenn das Änderungsvolumen zunimmt.
4. Nutzen Sie das Prinzip der minimalen Rechtevergabe und sandboxen Sie Agents
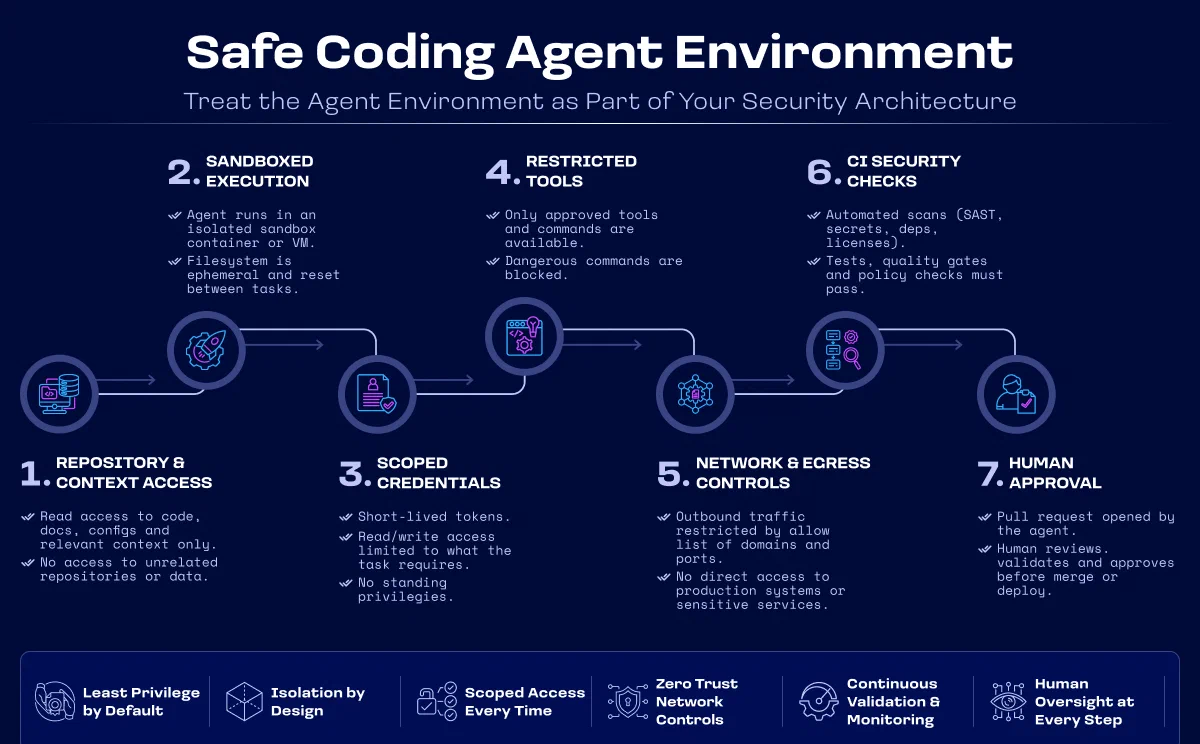
Ein Coding-Agent, der Befehle ausführen kann, ist Teil Ihres Sicherheitsmodells. Die aktuelle OWASP-Richtlinie empfiehlt, Agent-Runtimes in einer Sandbox auszuführen, den Dateisystem- und Tool-Zugriff zu beschränken, zeitlich begrenzte oder flüchtige Anmeldeinformationen zu verwenden, unnötigen Netzwerkzugriff zu blockieren und Repository-Inhalte sowie externe Informationen als potenziell nicht vertrauenswürdige Eingaben zu behandeln. OWASP identifiziert zudem indirekte Prompt-Injection (Indirect Prompt Injection) als Risiko im Entwicklungszyklus, da bösartige Anweisungen über Issues, Dokumentationen, Pull-Request-Kommentare, Webseiten oder angebundene Tools eingeschleust werden können. Ein Agent, der Tests ändert, benötigt keine Produktionsdaten, und ein Agent, der Frontend-Code bearbeitet, braucht keine Cloud-Administrationsrechte.
5. Steuern Sie Abhängigkeiten bewusst
Das Hinzufügen einer Abhängigkeit zu einem neuen Paket ist für einen Agenten oft der schnellste Weg, um einen Prompt zu erfüllen. Dies kann jedoch Schwachstellen, Lizenzprobleme, transitive Abhängigkeiten, Upgrade-Aufwand und eine weitere Komponente einführen, die das Unternehmen warten muss. Fordern Sie eine explizite Begründung für neue Abhängigkeiten und wenden Sie die üblichen Supply-Chain-Prüfungen an. Das Ziel ist nicht, null Abhängigkeiten zu haben, sondern ein bewusstes und kontrolliertes Wachstum derselben.
6. Prüfen Sie die architektonische Absicht, nicht nur die Syntax
Die wichtigste Review-Frage für agentengenerierten Code lautet nicht nur „Funktioniert das?“. Reviewer sollten sich auch fragen, ob die Änderung in dieses Modul gehört, etablierte Datengrenzen respektiert, bestehende Funktionen dupliziert, unnötige Abstraktionen einführt, Fehlerfälle sauber behandelt und auch ohne Zugriff auf die ursprüngliche Agent-Konversation verständlich bleibt. Software wird weitaus länger gewartet als generiert.
7. Behalten Sie die menschliche Verantwortung für die Architektur
Coding-Agents können Teams dabei helfen, Architekturen zu explorieren. Sie können Abhängigkeiten abbilden, unbekannte Komponenten zusammenfassen, Alternativen vergleichen und Refactoring-Arbeiten vorbereiten. Sie sollten jedoch nicht die architektonische Entscheidung selbst treffen. Produktstrategien, regulatorische Auflagen, erwartetes Wachstum, Migrationsbudgets, Teamkapazitäten, Betriebsrisiken und zukünftige Geschäftspläne liegen oft außerhalb des Repository-Kontexts. Der Agent kann Optionen liefern – die Verantwortung für die Konsequenzen verbleibt bei der technischen Führung.
Ein praktisches Governance-Modell für Coding-Agents
Unternehmen benötigen kein schwerfälliges KI-Governance-Programm, bevor sie mit Coding-Agents experimentieren. Sie brauchen jedoch klare Antworten auf vier Fragen: Was Agents tun dürfen, welche Regeln sie befolgen müssen, worauf sie zugreifen dürfen und was vor dem Mergen einer Änderung geschehen muss.
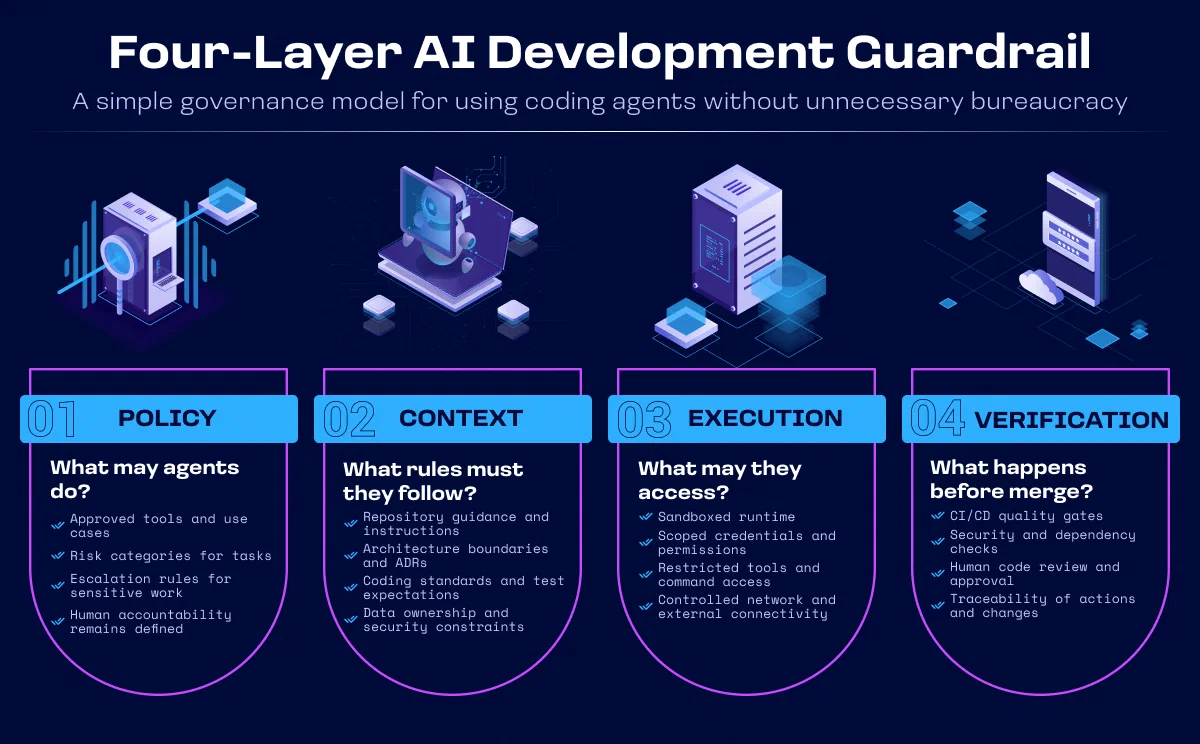
| Ebene | Frage | Typische Kontrollen |
|---|---|---|
| Richtlinie (Policy) | Was dürfen Agents tun? | Freigegebene Tools und Anwendungsfälle |
| Kontext (Context) | Welche Regeln müssen sie befolgen? | Repository-Leitfäden und Architekturbeschränkungen |
| Ausführung (Execution) | Worauf dürfen sie zugreifen? | Sandboxes, eingeschränkte Anmeldedaten, Werkzeugbeschränkungen |
| Verifizierung (Verification) | Was passiert vor dem Merge? | CI/CD-Sperren und menschliches Review |
Dieser Ansatz entspricht auch dem Prinzip des Secure Software Development Frameworks von NIST: Sicherheit sollte über den gesamten Softwareentwicklungszyklus hinweg integriert sein, anstatt als abschließende Kontrolle angehängt zu werden. KI-generierte Änderungen sollten im bestehenden sicheren Entwicklungsprozess verbleiben und nicht zu einer Abkürzung um diesen herum werden.
Messen Sie Ergebnisse, nicht KI-generierten Code
Codezeilen und die Anzahl der von Agents erstellten Pull Requests messen Aktivität, nicht Wert.
Ein weitaus nützlicheres Dashboard kombiniert Liefergeschwindigkeit mit Qualität, Zuverlässigkeit und Wartungsergebnissen:
- Durchlaufzeit für Änderungen (Lead Time for Changes) und Bereitstellungshäufigkeit (Deployment Frequency);
- Änderungsfehlerrate (Change Failure Rate) und unentdeckte Defekte (Escaped Defects);
- Review-Zeit und agentenbezogene Nacharbeit;
- Sicherheitsbefunde;
- Unnötiges Wachstum von Abhängigkeiten oder Code-Duplikation;
- Wartbarkeit von häufig geänderten Komponenten.
Der DORA-ROI-Leitfaden von Google aus dem Jahr 2026 zielt in die gleiche Richtung, indem er sich darauf konzentriert, wie sich technische Geschwindigkeit in geschäftlichen Nutzen übersetzt und wie viel Nacharbeit vermieden wird. Die eigentliche Frage ist, ob KI zusätzliche Entwicklungskapazitäten schafft, ohne die heutigen Zeiteinsparungen in die Wartungskosten von morgen zu verwandeln.
Eine schrittweise Adoptions-Roadmap
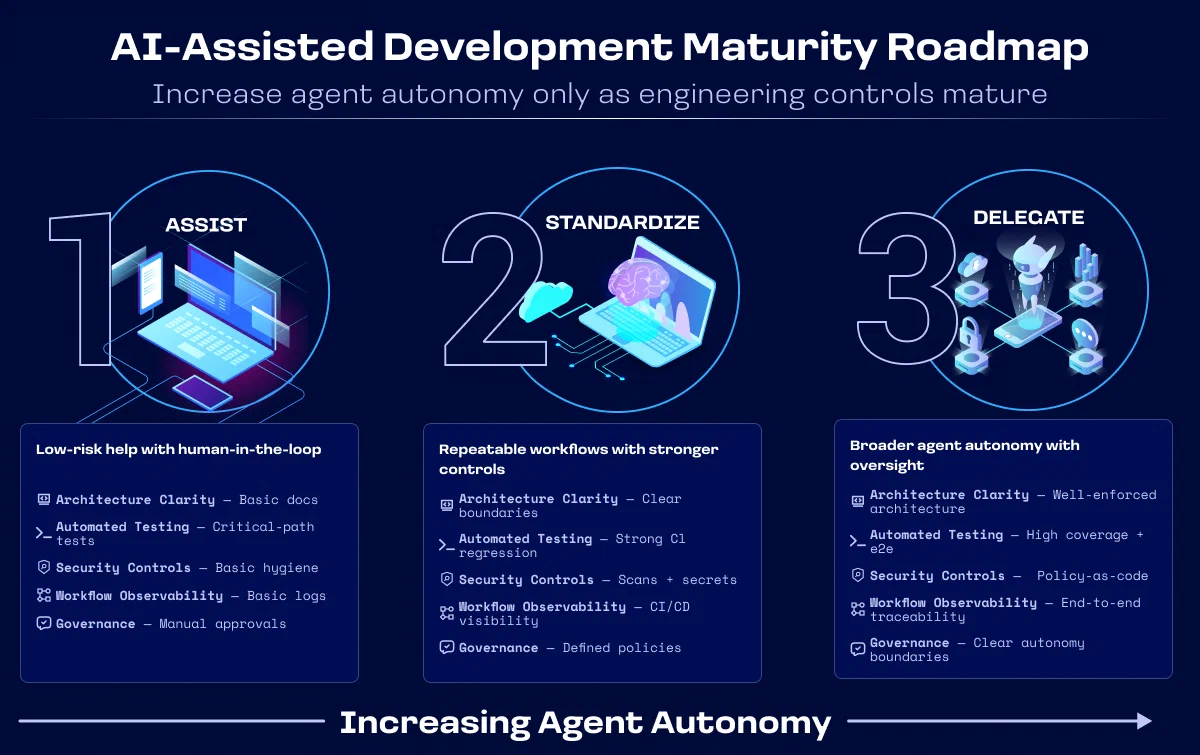
Stufe 1: Assistieren (Assist)
- Beginnen Sie mit risikoarmen, leicht zu verifizierenden Arbeiten: Dokumentation, Code-Erklärungen, Tests, isolierte Fehlerbehebungen und klar definierte Refactorings.
- Halten Sie die Berechtigungen eng und die normalen Review-Anforderungen aufrecht. Das Ziel ist es, zu lernen, wo Agents in Ihrer tatsächlichen Codebasis zuverlässig arbeiten, bevor Sie den Umfang erhöhen.
Stufe 2: Standardisieren (Standardize)
- Machen Sie erfolgreiche Experimente zu einer wiederholbaren Engineering-Praxis.
- Definieren Sie Repository-Anweisungen, Quality Gates, Richtlinien für Abhängigkeiten, Sicherheitskontrollen, Review-Erwartungen und die Kategorien von Arbeiten, die eine Freigabe durch erfahrene Entwickler erfordern.
- Auf dieser Stufe ist das Ziel eine konsistente Qualität, nicht isolierte Produktivitätsgewinne.
Stufe 3: Delegieren (Delegate)
- Erweitern Sie den Einsatz auf größere asynchrone oder parallele Agent-Workflows erst, wenn diese Kontrollen zuverlässig funktionieren.
- Fügen Sie Observability für Agent-Aktivitäten hinzu: Was wurde geändert, welche Tools wurden verwendet, welche Tests liefen, welche Berechtigungen wurden erteilt, wer hat die Arbeit überprüft und an welchen Stellen entsteht Nacharbeit.
Mehr Autonomie erfordert stärkere Feedbackschleifen und Governance, nicht weniger.
Der geschäftliche Nutzen ist kontrollierte Engineering-Geschwindigkeit
Der Business Case für Coding-Agents ist nicht „mehr Code“. Die meisten Unternehmen sind nicht durch einen Mangel an Quellcodezeilen eingeschränkt. Der Wert liegt in der zusätzlichen Kapazität für wertvolle Entwicklungsarbeit, während erfahrene Mitarbeiter sich auf Architektur, Sicherheit, Produktentscheidungen, Zuverlässigkeit und komplexe Systemänderungen konzentrieren können.
Wenn die umgebende Architektur gesund ist, kann KI-gestützte Entwicklung Teams helfen, routinemäßige Implementierungsarbeiten schneller zu erledigen. Wenn die Architektur eng gekoppelt, schlecht dokumentiert oder bereits mit erheblichen technischen Schulden belastet ist, legt ein höheres Änderungsvolumen diese Schwachstellen einfach noch schneller offen.
Das macht die Einführung von Coding-Agents zu einem nützlichen Prüfstein für die Architektur. Wenn Ihr Team Änderungen schneller generieren kann, als es sie sicher reviewen, integrieren und betreiben kann, liegt der eigentliche Engpass möglicherweise nicht mehr bei der Entwicklerproduktivität. Es ist vielmehr die darunter liegende Softwarearchitektur und das Bereitstellungssystem.
Die wichtigsten Erkenntnisse (Key Takeaways)
- Coding-Agents können über Repositories und Entwicklungsworkflows hinweg agieren und schlagen nicht mehr bloß Code-Snippets vor.
- KI kann den Bereitstellungsdurchsatz steigern, ohne automatisch die Lieferstabilität zu verbessern.
- Begrenzte Autonomie ist sicherer, als jedem Agenten denselben Umfang und dieselben Berechtigungen zu geben.
- Architekturregeln, automatisierte Quality Gates, Sandboxing, Dependency-Governance und menschliche Reviews gewinnen an Bedeutung, je mehr die Autonomie der Agents zunimmt.
- Messen Sie Nacharbeit, Zuverlässigkeit, Wartbarkeit und Geschäftsergebnisse parallel zur Geschwindigkeit.
- Behalten Sie die menschliche Verantwortung der technischen Führung für architektonische Entscheidungen bei.
Fazit
KI-gestützte Softwareentwicklung im Jahr 2026 wird am besten als eine Veränderung des gesamten Engineering-Systems behandelt, nicht bloß als ein neues Entwicklerwerkzeug.
Coding-Agents können eine starke Entwicklungsorganisation noch schneller machen. Sie können jedoch auch Code-Duplizierung, architektonische Drift, schwache Abhängigkeiten, Sicherheitsrisiken und technische Schulden beschleunigen, wenn die umgebenden Kontrollen nicht bereit sind.
Der nachhaltige Ansatz ist simpel: Erhöhen Sie die Autonomie der Agents nur in dem Maße, wie Ihre Architektur, Ihre Tests, Ihr Review-Prozess, Ihre Sicherheitskontrollen und Ihre Feedbackschleifen in der Lage sind, diese zu unterstützen.
Wenn Ihr Unternehmen bereits mit architektonischer Komplexität, technischen Schulden oder einer Modernisierungs-Roadmap zu kämpfen hat, können Coding-Agents diese Hürden schnell offenlegen. trust!NICKOL unterstützt Unternehmen dabei, Softwarearchitekturen zu bewerten, sichere Governance-Rahmen für KI-gestütztes Engineering aufzubauen und technische Entscheidungen zu treffen, die eine schnellere Bereitstellung ermöglichen, ohne die langfristige Wartbarkeit zu opfern. Lassen Sie uns ins Gespräch kommen!
Häufig gestellte Fragen (FAQs)
Was ist KI-gestützte Softwareentwicklung?
KI-gestützte Softwareentwicklung nutzt künstliche Intelligenz zur Unterstützung von Aktivitäten wie Codegenerierung, Testen, Debugging, Dokumentation, Refactoring, Review und Repository-Analyse. Agentenbasierte Workflows gehen weiter, indem sie es KI-Systemen ermöglichen, mehrere Aktionen selbstständig auszuführen, um eine Entwicklungsaufgabe abzuschließen.
Was ist ein Coding-Agent?
Ein Coding-Agent ist ein KI-System, das innerhalb einer Entwicklungsumgebung agieren kann, anstatt nur Code vorzuschlagen. Je nach Werkzeugen und Berechtigungen kann er Repositories analysieren, Dateien bearbeiten, Befehle ausführen, Tests ausführen und Änderungen für das Review vorbereiten.
Verursachen KI-Coding-Agents technische Schulden?
Nicht automatisch. Das Risiko steigt, wenn Agents Änderungen schneller produzieren, als Teams Architektur-, Test-, Abhängigkeits-, Sicherheits- und Review-Standards durchsetzen können. Agents können auch Inkonsistenzen replizieren, die bereits in der Codebasis vorhanden sind.
Welche Aufgaben lassen sich am sichersten an Coding-Agents delegieren?
Gute Einstiegspunkte sind Aufgaben mit engem Rahmen und klaren Akzeptanzkriterien wie Dokumentation, Tests, Code-Erklärungen, Behebung von Lint-Fehlern, klar spezifizierte Bugs und mechanische Refactorings. Arbeiten mit höherem Risiko erfordern eine intensivere menschliche Begleitung.
Sollte KI-generierter Produktionscode von Menschen überprüft werden?
Ja. Die menschliche Verantwortung muss im Prozess verbleiben, insbesondere bei Sicherheit, Architektur, Infrastruktur, Geschäftslogik, öffentlichen APIs und sensiblen Daten. Die Tiefe der Überprüfung kann risikobasiert sein, aber KI-generierte Änderungen sollten normale Engineering-Kontrollen nicht umgehen, nur weil ein Agent sie erstellt hat.
Wie können Unternehmen KI-generierte technische Schulden verhindern?
Nutzen Sie klare architektonische Leitlinien, kleine und überschaubare Änderungen, automatisierte Tests und Sicherheitsprüfungen, minimale Rechtevergabe, Sandboxing, Dependency-Governance, menschliche Verantwortung für die Architektur und Metriken, die Nacharbeit, Defekte, Zuverlässigkeit und Wartbarkeit erfassen.

Alexander Nickol
Software-Architekt und Entwickler
Ich begeistere mich für Programmiersprachen und Softwarearchitektur. Ich biete eine große Bandbreite an Fähigkeiten, unternehmerisches Handeln und lösungsorientiertes Denken in Bereichen wie Softwarearchitektur, Softwaredesign und Softwareentwicklung in Rust und Java.
Ähnliche Artikel
Performance Engineering auf Solana in 2026: Optimierung von Compute, Kosten und Latenz
Optimieren Sie Solana Compute Units, Priority Fees und End-to-End-Latenz im Jahr 2026 mit praxisnahen Anleitungen für zuverlässige Anwendungen in Produktionsqualität.
Software skalierbar gestalten: Vom Startup zum Enterprise-System
Lernen Sie, wie Sie skalierbare Software entwerfen – mit einem praktischen, stufenweisen Framework, das Architekturmuster, Datenbankskalierung und Cloud-Infrastruktur vom Startup bis zum Enterprise-Team abdeckt.
Wann sollten Sie einen Software-Architektur-Consultant engagieren?
Erfahren Sie, wann ein Software-Architektur-Consultant für Ihr Unternehmen sinnvoll ist und wie Sie Warnsignale wie Skalierungsprobleme und technische Schulden frühzeitig erkennen.