Software skalierbar gestalten: Vom Startup zum Enterprise-System
Lernen Sie, wie Sie skalierbare Software entwerfen – mit einem praktischen, stufenweisen Framework, das Architekturmuster, Datenbankskalierung und Cloud-Infrastruktur vom Startup bis zum Enterprise-Team abdeckt.
Inhaltsverzeichnis
Das häufigste Scheitern von Startup-Software liegt nicht an einem schlechten MVP. Es liegt an einem guten MVP, welcher auf einer Basis aufbaut, die das Wachstum des Unternehmens nicht unterstützen kann. Gründer entwickeln schnell, gewinnen erste Kunden und nehmen an, dass die Codebasis einfach mit dem Unternehmen „mitwachsen“ wird. Das tut sie jedoch selten. Anfang an zu wissen, wie man skalierbare Software entwirft, unterscheidet Unternehmen, die reibungslos skalieren, von denen, die zu einem kostspieligen Rewrite gezwungen sind.
Dies ist kein hypothetisches Risiko. Teams, die skalierbare Software-Architektur in den ersten 12 bis 18 Monaten ignorieren, stehen in der Regel vor einem vollständigen oder teilweisen Neuaufbau, sobald sie die Marke von 10.000 bis 50.000 aktiven Nutzern überschreiten. Dieser Prozess verschlingt enorme Entwicklungszeit und viel Geld. Die gute Nachricht: Skalierbare Software erfordert an Tag eins keine Infrastruktur auf Enterprise-Niveau. Sie erfordert die richtigen Entscheidungen, getroffen in der richtigen Reihenfolge, auf der jeweiligen Stufe des Wachstums.
Was „skalierbare Software“ wirklich bedeutet (über die reine Nutzeranzahl hinaus)
Software-Skalierbarkeit wird oft auf das „Bewältigen von mehr Traffic“ reduziert, aber diese Betrachtungsweise greift zu kurz. Ein System kann eine Traffic-Spitze überleben und dennoch als Unternehmenswert scheitern, wenn für jede neue Funktion die gesamte Codebasis angepasst werden muss. Echte Skalierbarkeit ist architektonischer Natur und nicht bloß performancebasiert.
Der Unterschied zwischen der Skalierung von Performance und Komplexität
Die Performance einer Anwendung (wie Antwortzeiten, Durchsatz und Uptime) ist das, was die meisten Teams messen. Doch die Systemleistung unter Last ist nur die halbe Wahrheit. Die andere Hälfte ist die organisatorische Skalierbarkeit: Können fünf Entwicklerteams gleichzeitig an dieser Codebasis arbeiten, ohne sich gegenseitig in die Quere zu kommen? Ein System, das bei Performance-Benchmarks hervorragend abschneidet, kann strukturell dennoch unskalierbar sein, wenn es keine parallele Entwicklung unterstützt.
Warum „Skalieren von Tag eins an“ oft ein schlechter Rat ist
Vorzeitige Optimierung (Premature Optimization) is einer der teuersten Fehler beim frühen Entwurf skalierbarer Software. Teams, die für Millionen von Nutzern planen, bevor sie den Product-Market-Fit validiert haben, verschwenden routinemäßig 30 % bis 50 % mehr Entwicklungszeit für eine Infrastruktur, die bei dieser Größe vielleicht nie benötigt wird. Das bessere Prinzip: Bauen Sie für die Skalierung, die Sie in den nächsten 3 bis 5 Jahren realistisch vorhersehen können, und zwar so, dass Sie die in Zukunft eventuell benötigte Skalierung nicht strukturell blockieren.
Die wahren Kosten, wenn Skalierbarkeit früh ignoriert wird
Technische Schulden, die mit dem Team anwachsen
Technische Schulden verhalten sich wie finanzielle Schulden: Kleine Beträge sind tragbar, aber ungelöste Schulden summieren sich durch Zinseszinsen. Eine Abkürzung, die genommen wird, um einen Starttermin einzuhalten, wird zum Blocker für drei zukünftige Features. Wenn das Team wächst, werden die Zinsen für diese Schulden nicht nur in Entwicklungszeit gezahlt, sondern auch in langsamerem Onboarding und steigenden Fehlerquoten.
Das typische Muster: Was passiert, wenn Startups komplett neu bauen müssen
Muster für gescheiterte Skalierung, die ein Neubau erfordert: ein Monolith ohne interne Grenzen, eine gemeinsam genutzte Datenbank ohne klare Datenzuständigkeit und ein wachsendes Entwicklerteam, das nicht ohne Konflikte deployen kann. Der darauf folgende Neubau dreht sich gar nicht primär um skalierbares Systemdesign; es geht vielmehr darum, jahrelange, undokumentierte Kopplungen zu entwirren. Das ist weitaus teurer, als von Anfang an modulare Grenzen zu ziehen.
Kernprinzipien skalierbarer Software-Architektur
Vier Prinzipien bestimmen, ob eine skalierbare Anwendungsarchitektur ohne einen kompletten Rewrite wachsen kann:
- Lose Kopplung (Loose Coupling): Unabhängige Komponenten sollten austauschbar sein, ohne unbeteiligten Code anzufassen.
- Zustandslosigkeit (Statelessness): Anwendungsserver sollten Session-Daten nicht lokal speichern, um horizontale Skalierung zu ermöglichen.
- Geplante Redundanz (Designed Redundancy): Keine Single Points of Failure, sobald echte Kunden auf die Uptime angewiesen sind.
- Klare Datengrenzen (Clear Data Boundaries): Jeder Service besitzt seine eigenen Daten. Dies verhindert verstrickte Migrationen, die Monolithen bei der Skalierung plagen.
Lose Kopplung und modulares Design
Modulares Design bedeutet, dass eine Änderung im Abrechnungsmodul nicht das Risiko birgt, Benachrichtigungen lahmzulegen. Dies ist das Fundament der Skalierbarkeit von Software-Architekturen: kein spezifisches Muster, sondern eine Disziplin, die unabhängig vom gewählten Muster konsequent angewendet werden muss.
Zustandslosigkeit und horizontale Skalierung
Horizontale Skalierung (das Hinzufügen weiterer Instanzen anstelle von größeren Servern) funktioniert nur, wenn die Anwendungsserver zustandslos sind. Session-Daten gehören in einen gemeinsam genutzten Speicher (Redis, eine Datenbank), nicht in den Arbeitsspeicher des Servers, da die Last sonst nicht zuverlässig auf die Instanzen verteilt werden kann.
Für den Fehlerfall planen (Redundanz und Ausfallsicherheit)
Enterprise-Kunden erwarten, dass Cloud-Skalierbarkeit auch Ausfallsicherheit (Fault Tolerance) umfasst: Keine einzelne Datenbankinstanz, kein einzelner Server und keine einzelne Region, deren Ausfall das gesamte Produkt lahmlegt. Dies frühzeitig und sei es nur minimal einzuplanen, ist weitaus günstiger, als es später unter dem Druck einer SLA-Frist nachzurüsten.
Das richtige Architekturmuster für Ihre Wachstumsphase wählen
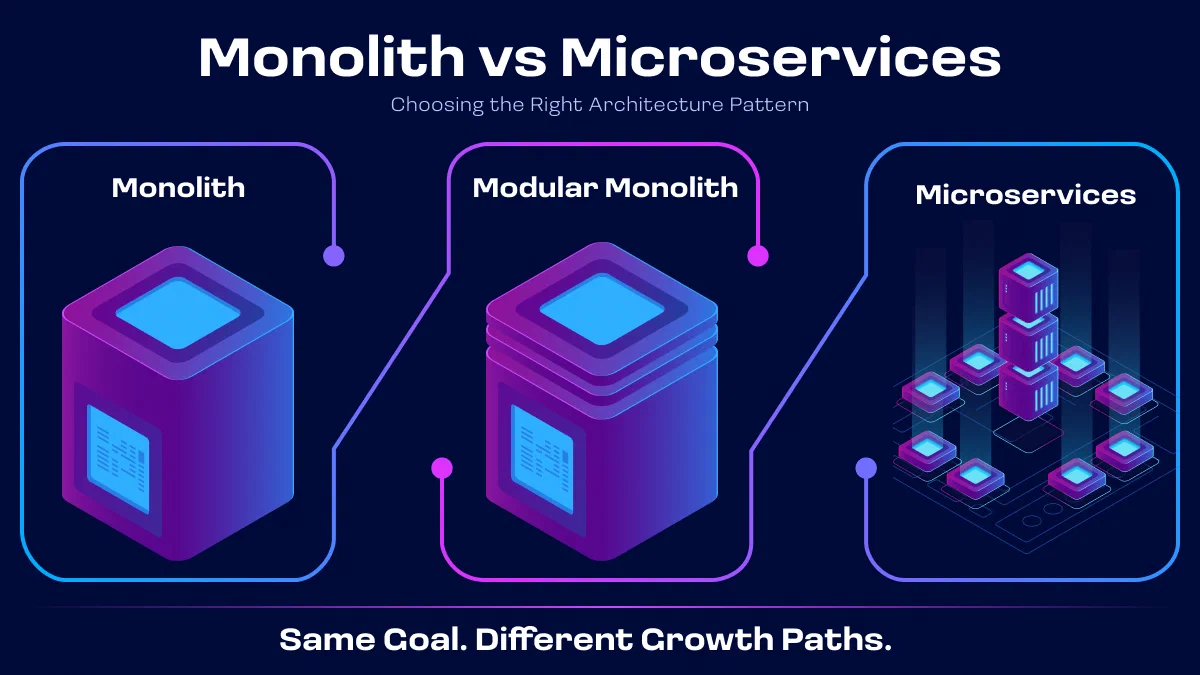
| Monolith | Modularer Monolith | Microservices | |
|---|---|---|---|
| Ideal für | Pre-PMF-Startups | Growth-Stage-Teams (10 bis 50 Entwickler) | Enterprise- und High-Scale-Teams |
| Deployment-Komplexität | gering | gering bis moderat | hoch |
| Operationaler Overhead | minimal | moderat | erheblich |
| Entwicklungszeit | sehr schnell | schnell | langsam |
Monolith-First: Wann es tatsächlich die klügere Wahl ist
Ein Monolith reduziert die Deployment-Komplexität und vermeidet verfrühte Probleme verteilter Systeme (Netzwerklatenz, Teilzeitausfälle, serviceübergreifende Konsistenz). Durch die Vereinfachung gewinnt man Geschwindigkeit; der Fehler ist nicht die Wahl eines Monolithen, sondern der Aufbau eines unstrukturierten Monolithen.
Modulare Monolithen als goldener Mittelweg
Ein modularer Monolith ist eine einzelne deploybare Anwendung, die intern in klar voneinander abgegrenzte Module gegliedert ist, ohne dass eine direkte Kopplung auf Datenbankebene besteht. Dies ist die praktische Antwort für die meisten Teams, die sich fragen, wie sie skalierbare Software entwerfen können, ohne vorab zu viel in eine Infrastruktur zu investieren, die sie noch gar nicht benötigen.
Microservices: Wenn Sie sich die Komplexität verdient haben
Microservices sind erst dann gerechtfertigt, wenn Teamgröße, Deployment-Unabhängigkeit oder ein spezifischer Engpass die zusätzlichen Betriebskosten rechtfertigen. Dies ist in der Regel ab etwa 40 bis 60 Entwicklern der Fall oder wenn die Skalierungsanforderungen eines bestimmten Moduls drastisch vom Rest des Systems abweichen.
Datenbankdesign, das mit Ihnen wächst
Vertikale vs. horizontale Skalierung von Datenspeichern
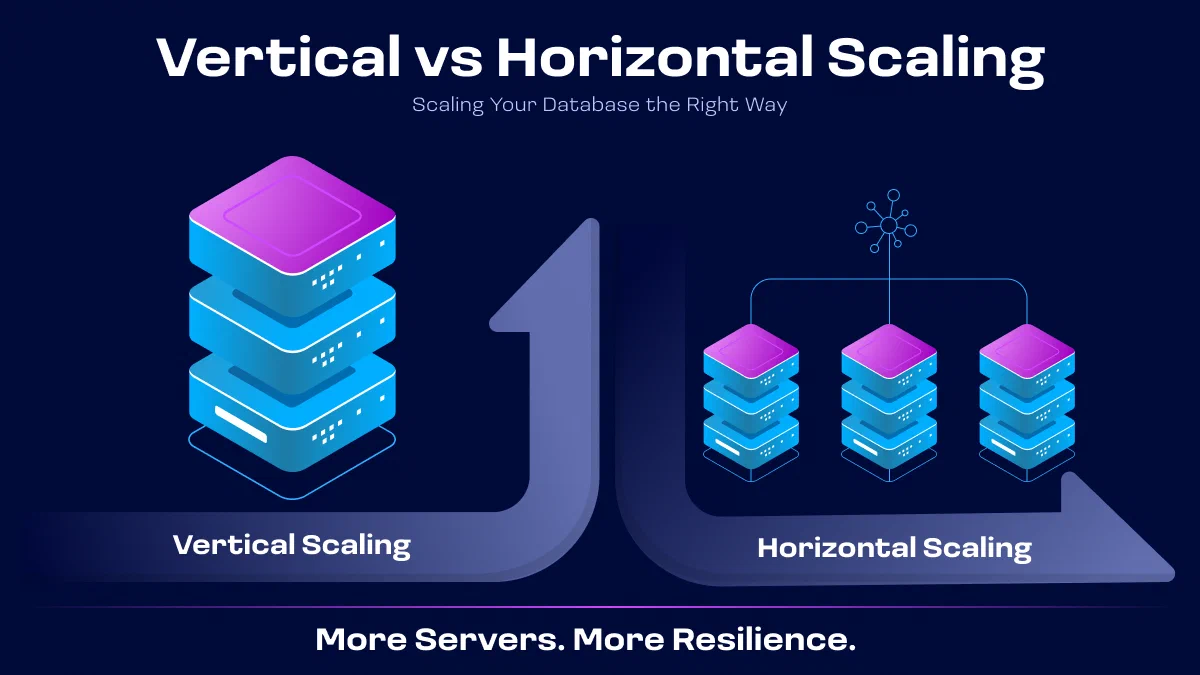
Vertikale Skalierung (stärkere Server) ist einfach, stößt jedoch an eine Obergrenze und erzeugt einen Single Point of Failure. Horizontale Skalierung durch Read Replicas und Sharding verteilt die Last und unterstützt einen weitaus höheren Durchsatz, allerdings auf Kosten einer höheren Komplexität bei der Konsistenzhaltung.
Sharding, Replikation und Read Replicas erklärt
Die praktische Reihenfolge: eine einzelne, gut indizierte primäre Datenbank, dann Read Replicas für Abfragen und Berichte, darauf folgend eine Caching-Ebene und erst dann Sharding, wenn die Abfrageleistung einer Tabelle spürbar einbricht (oft im Bereich von 10 bis 50 Millionen Zeilen).
Vorzeitige Datenbankoptimierung vermeiden
Sharding is eine der am schwersten rückgängig zu machenden Architekturentscheidungen überhaupt. Vermeiden Sie es, bis die tatsächliche Last es zwingend erfordert; der betriebliche Mehraufwand zahlt sich auf bloßen Verdacht hin nicht aus.
Infrastruktur- und Cloud-Entscheidungen für langfristiges Wachstum
Containerisierung und Orchestrierung (Docker, Kubernetes): Wann der richtige Zeitpunkt ist
Containerisierung lohnt sich schon früh, um die Konsistenz der Umgebungen zu sichern. Orchestrierung (Kubernetes) löst zwar reale Probleme bei hoher Skalierung, bringt jedoch erhebliche Komplexität mit sich. Die meisten Teams mit weniger als 20 Entwicklern sind mit verwalteten Plattformen (Managed Services) besser bedient als mit einem selbst verwalteten Cluster.
Auto-Scaling, Load Balancing und CDN-Strategie
Cloud-Skalierbarkeit basiert auf dem Zusammenspiel dreier Komponenten: Auto-Scaling für Rechenkapazitäten, das sich dem Traffic anpasst, Load Balancing zur Verteilung der Anfragen auf die Instanzen und ein CDN, das statische Inhalte näher an die Nutzer bringt. All diese Faktoren beeinflussen die Systemperformance unter realen Bedingungen direkt.
Multi-Region- und Hochverfügbarkeits-Überlegungen für Enterprise-Readiness
Multi-Region-Deployments werden zu einer zwingenden Anforderung, sobald Gespräche über Enterprise-Software-Architekturen beginnen. Uptime-SLAs und Vorgaben zur Datenhaltung (Data Residency) sind gängige Vertragsbedingungen bei regulierten oder globalen Kunden.
Aufbau einer Engineering-Kultur, die mit dem Code mitwächst
CI/CD-Pipelines und automatisierte Tests als Skalierungspflicht
Teams, die ohne CI/CD arbeiten, verzeichnen bei wachsender Codebasis meist einen Einbruch der Deployment-Frequenz um 60 % bis 80 % , weil die manuelle Überprüfung nicht mehr Schritt halten kann. Ein Ziel von über 70 % Testabdeckung der zentralen Geschäftslogik ist ein solider Benchmark für die Enterprise-Readiness.
Dokumentations- und Onboarding-Systeme für wachsende Teams
Undokumentierte Architekturentscheidungen werden ab etwa 8 bis 10 Entwicklern zu einer Wachstumsbremse. Implizites Wissen, das nur in den Köpfen der Mitarbeiter existiert, verlangsamt jedes Onboarding und erhöht das Risiko für unbeabsichtigte technische Schulden.
Governance-, Sicherheits- und Compliance-Anforderungen in der Enterprise-Phase
SOC 2, DSGVO-Konformität und rollenbasierte Zugriffskontrolle (RBAC) entwickeln sich in der Enterprise-Vertriebsphase von „nice-to-have“ zu geschäftskritischen K.-o.-Kriterien. Diese nachträglich in ein System ohne klare Datengrenzen einzubauen, ist um ein Vielfaches teurer, als sie schrittweise von Anfang an zu etablieren.
Signale, dass es Zeit für eine Re-Architektur ist (und wie man sie ohne Downtime meistert)
Wichtige Performance- und Teamgrößen-Trigger, auf die Sie achten sollten
- Die Deployment-Frequenz sinkt trotz eines wachsenden Teams
- Ein bestimmtes Modul verursacht fortlaufend die meisten Produktionsvorfälle
- Die Einarbeitungszeit neuer Entwickler überschreitet 4 bis 6 Wochen
- Enterprise-Interessenten äußern Bedenken bezüglich SLAs oder Compliance
- Die Infrastrukturkosten steigen schneller als das Nutzerwachstum
Das Strangler-Fig-Pattern und inkrementelle Migrationsstrategien
Das Strangler-Fig-Pattern (die schrittweise Umleitung des Traffics vom alten System auf neue Komponenten, bis das Altsystem vollständig abgelöst werden kann) vermeidet die Ausfallzeiten und Risiken eines kompletten Rewrites. So kann das Team die Systemarchitektur modernisieren, ohne die Feature-Entwicklung einfrieren zu müssen.
Häufige Skalierungsfehler, die Startups machen
Vorzeitiges Over-Engineering
Für Millionen von Nutzern zu bauen, während man erst 500 Anmeldungen hat, verzögert das Einzige, was über das Überleben entscheidet: das Erreichen des Product-Market-Fits.
Zu geringe Investitionen in Observability und Monitoring
Logging, Monitoring und Alerting sind oft die ersten Dinge, die unter Zeitdruck gestrichen werden. Ohne sie können Teams Engpässe in der Anwendungsperformance nicht diagnostizieren, bevor sie zu Ausfällen führen. Dadurch wird aus einer geplanten Optimierung ein reaktiver, teurer Noteinsatz.
Ein praktischer Fahrplan: Software Stufe für Stufe skalieren
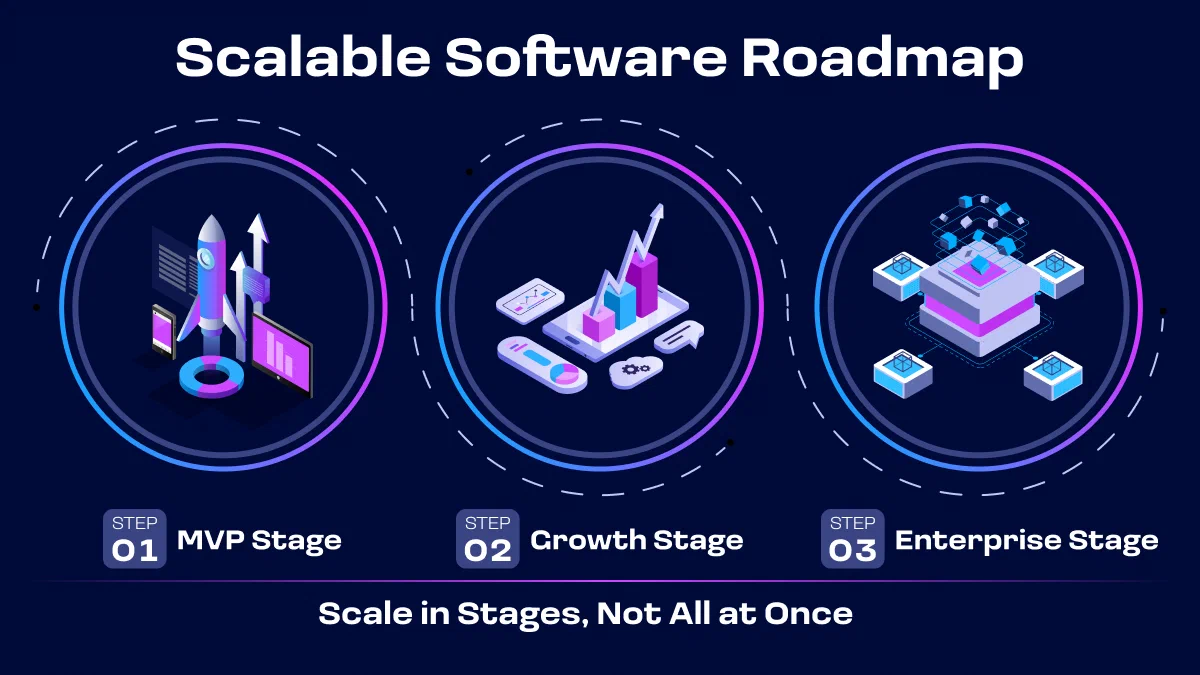
MVP-Phase (0 bis 10.000 Nutzer)
Modularer Monolith, eine einzelne gut indizierte Datenbank, containerisiertes Deployment, grundlegendes CI/CD und schlanke Fehlerverfolgung (z. B. Sentry.io). Die Iterationsgeschwindigkeit zählt hier mehr als eine hochkomplexe Infrastruktur.
Growth-Phase (Product-Market-Fit bis Series B)
Read Replicas und Caching, Auto-Scaling für Rechenkapazitäten, Metrikerfassung & Dashboards (z. B. Prometheus & Grafana), Auslagerung von 1 bis 2 hochbelasteten Modulen in eigenständige Services bei Engpässen, über 70 % Testabdeckung der kritischen Pfade.
Enterprise-Phase (Hochverfügbarkeit, Compliance, globale Skalierung)
Multi-Region-Infrastruktur, SOC-2-/DSGVO-Compliance-Programm, vollständiger Observability-Stack (einschließlich APM & verteiltem Tracing z. B. Instana) und Microservices dort, wo Team-Autonomie oder Skalierung es wirklich erfordern, nicht standardmäßig.
| Phase | Nutzerbereich | Architektur-Priorität | Observability-Tools | Wichtigster Meilenstein |
|---|---|---|---|---|
| MVP | 0 bis 10.000 Nutzer | Modularer Monolith, einzelne indizierte Datenbank | Fehlerverfolgung (z. B. Sentry.io) | Iterations-geschwindigkeit |
| Growth | PMF bis Series B | Read Replicas, Caching, Auto-Scaling | Metriken & Dashboards (z. B. Prometheus & Grafana) | Erste Service-Extraktion |
| Enterprise | Ab Series C | Multi-Region, Compliance, Observability | APM & Tracing (z. B. Instana) | Enterprise-ready SLA |
Die wichtigsten Erkenntnisse
- Software-Skalierbarkeit ist architektonischer und organisatorischer Natur, nicht bloß das Bewältigen von mehr Traffic.
- Ein modularer Monolith schneidet für die meisten Startups in der Growth-Phase besser ab als ein unstrukturierter Monolith oder voreilige Microservices.
- Datenbankgrenzen gehören zu den am schwersten zu korrigierenden Entscheidungen. Ziehen Sie diese frühzeitig richtig, auch wenn die Infrastruktur einfach bleibt.
- Eine Re-Architektur sollte durch messbare Trigger ausgelöst werden, nicht durch einen starren Zeitplan.
- Das Strangler-Fig-Pattern ermöglicht eine schrittweise Migration, ohne die Feature-Entwicklung zu stoppen.
Fazit
Zu lernen, wie man skalierbare Software entwirft, bedeutet weniger, frühzeitig Enterprise-Infrastruktur einzuführen, sondern vielmehr, Entscheidungen in der richtigen Reihenfolge zu treffen: modulare Grenzen vor Microservices, saubere Datenmodelle vor Sharding, Observability vor der Krise. Unternehmen, die skalierbare Software-Architektur als einen fortlaufenden, stufenweisen Prozess statt als einmalige Entscheidung begreifen, bauen Systeme, die das Wachstum unterstützen, anstatt es irgendwann zu blockieren.
Diese Reihenfolge richtig hinzubekommen, ist genau der Punkt, an dem die meisten Teams externe Expertise benötigen, nicht bloß Dokumentation. Wenn Sie abwägen, wann Sie modularisieren, wann Sie Microservices einführen oder wie Sie Ihre Datenebene strukturieren sollten, bevor es zu einem Migrationsproblem wird, unterstützt trust!NICKOL Sie bei Software-Architektur-Herausforderungen, um eine Skalierung vom ersten Release bis zum Enterprise-Wachstum zu ermöglichen. Sprechen Sie mit einem Software-Architektur-Berater!
Häufig gestellte Fragen (FAQ)
Was ist ein „PMF-Startup“?
„PMF“ steht für Product-Market Fit (Produkt-Markt-Übereinstimmung). Ein Pre-PMF-Startup experimentiert noch, um ein Produkt zu finden, das der Markt aktiv nachfragt und bezahlt. Das bedeutet, dass die Architektur auf extreme Flexibilität und Iterationsgeschwindigkeit optimiert werden muss. Ein Post-PMF-Startup (in der Growth-Phase) hat sein Produkt validiert und muss die Architektur nun so ausrichten, dass sie planbares Wachstum bewältigen kann.
Sollten Startups von Anfang an für extreme Skalierung bauen?
Nein. Startups sollten für 12 bis 18 Monate realistisches Wachstum planen und Muster wie einen modularen Monolithen nutzen, die eine spätere Skalierung nicht blockieren, anstatt die Architektur vor dem validierten Product-Market-Fit auf Enterprise-Lasten auszulegen.
Was ist der größte Unterschied zwischen Startup- und Enterprise-Software-Architektur?
Startup-Architektur optimiert auf Iterationsgeschwindigkeit mit einem kleinen Team; Enterprise-Software-Architektur optimiert auf Zuverlässigkeit, Compliance und die Autonomie mehrerer Teams im großen Maßstab.
Ist ein Monolith oder Microservices besser für eine gesellschaftliche Skalierung?
Ein modularer Monolith ist während der Growth-Phase meist die bessere Wahl. Microservices sind erst dann sinnvoll, wenn die Teamgröße oder spezifische Engpässe die zusätzliche betriebliche Komplexität rechtfertigen.
Woher weiß man, wann es Zeit für eine Re-Architektur des Systems ist?
Achten Sie auf sinkende Deployment-Frequenzen, gehäufte Vorfälle in einem einzelnen Modul, Einarbeitungszeiten von über 4 bis 6 Wochen und Bedenken von Enterprise-Kunden bezüglich Compliance oder SLAs.
Welche Tools helfen dabei, Software vom Startup bis zum Enterprise zu skalieren?
Containerisierung, verwaltete Auto-Scaling-Infrastruktur, CDN- und Load-Balancing-Dienste, CI/CD-Pipelines und Observability-Plattformen bilden das praktische Toolkit über alle Phasen hinweg. In der Anfangsphase bietet eine schlanke Fehlerverfolgung (z. B. Sentry.io) maximale Transparenz bei minimalem Einrichtungsaufwand. Während der Growth-Phase führen Teams in der Regel Metriken & Dashboards (z. B. Prometheus & Grafana) ein, um die Ressourcunauslastung und den Systemzustand zu überwachen. Beim Übergang zur Enterprise-Phase werden fortschrittlichere APM- und verteilte Tracing-Lösungen (z. B. Instana) implementiert, um komplexe verteilte Aufrufe und die gesamte Infrastruktur zu überwachen.

Alexander Nickol
Software-Architekt und Entwickler
Ich begeistere mich für Programmiersprachen und Softwarearchitektur. Ich biete eine große Bandbreite an Fähigkeiten, unternehmerisches Handeln und lösungsorientiertes Denken in Bereichen wie Softwarearchitektur, Softwaredesign und Softwareentwicklung in Rust und Java.
Ähnliche Artikel
Performance Engineering auf Solana in 2026: Optimierung von Compute, Kosten und Latenz
Optimieren Sie Solana Compute Units, Priority Fees und End-to-End-Latenz im Jahr 2026 mit praxisnahen Anleitungen für zuverlässige Anwendungen in Produktionsqualität.
KI-gestützte Softwareentwicklung in 2026: Wie Sie Coding-Agents ohne technische Schulden einsetzen
Erfahren Sie, wie Coding-Agents die Softwarebereitstellung in 2026 verändern, wo sie den größten Nutzen bringen und welche architektonischen Leitplanken technische Schulden verhindern.
Wann sollten Sie einen Software-Architektur-Consultant engagieren?
Erfahren Sie, wann ein Software-Architektur-Consultant für Ihr Unternehmen sinnvoll ist und wie Sie Warnsignale wie Skalierungsprobleme und technische Schulden frühzeitig erkennen.